Notes de mise à jour

Consultez les informations actualisées concernant les améliorations apportées au produit, les corrections de bogues et les nouvelles fonctionnalités ajoutées à chaque version.

v6.17.0

La version 6.17.0 de WProofreader Core intègre le moteur de relecture allemand basé sur l'IA v3.1, qui offre des corrections grammaticales et de ponctuation améliorées ; étend les descriptions et les catégories des corrections de relecture par IA à l'allemand et à l'espagnol ; enrichit les dictionnaires de plus de 970 nouveaux mots ; met à jour le moteur grammatical algorithmique avec des améliorations pour le portugais et l'italien ; améliore les suggestions de l'assistant de rédaction basé sur l'IA ; et corrige plusieurs failles de sécurité.

📝 En bref

  • Lancement du moteur de relecture allemand basé sur l'IA (v3.1) avec des corrections améliorées
  • Extension de la classification des correspondances issues de la relecture par IA et des descriptions de corrections sélectionnées aux langues allemande et espagnole
  • Des dictionnaires enrichis comprenant plus de 970 nouveaux mots répartis sur cinq langues, ainsi que 170 noms propres et abréviations communs
  • Amélioration de la terminologie médicale en anglais et en espagnol ; prise en charge étendue des dialectes anglais
  • Mise à jour du moteur de grammaire tiers, avec des améliorations pour le portugais et l'italien
  • Mises à jour de sécurité pour Micrometer et Netty visant à corriger des fuites de mémoire et des problèmes de validation des certificats

🛠 Améliorations

Relecture assistée par l'IA

  • Lancement du moteur de correction automatique allemand basé sur l'IA (v3.1), offrant une précision améliorée pour les verbes séparables, les verbes modaux au passé simple, les constructions à la voix passive, l'accord du sujet et du verbe, ainsi que les corrections de ponctuation.
  • La classification des correspondances a été étendue à l'allemand et à l'espagnol, ce qui permet désormais de disposer de catégories et de descriptions de règles harmonisées dans ces langues. Les utilisateurs bénéficient désormais d'explications cohérentes et claires concernant les corrections suggérées en allemand et en espagnol, d'une qualité équivalente à celle des commentaires en anglais.
  • Améliorations supplémentaires apportées dans différentes langues : gestion de la ponctuation en anglais, styles de guillemets et espacement des tirets courts en allemand, ainsi que nombres ordinaux, tirets longs, espacement et deux-points en espagnol.

Grammaire

  • Mise à jour de LanguageTool vers la version du 20 août 2026.
  • Mise à jour de la logique grammaticale du portugais avec une règle modifiée. Cette règle gère l'utilisation correcte des traits d'union dans les mots formés à partir de préfixes, conformément à l'Accord orthographique portugais. La liste des exceptions a été étendue afin de reconnaître le trait d'union insécable et le trait d'union U+2010, ce qui évite que des formes composées valides ne soient signalées à tort.
  • Mise à jour de la logique grammaticale italienne avec 6 règles modifiées. Correction des règles relatives aux articles pour les anglicismes dont le pluriel peut avoir la même forme écrite que le singulier, tels que « meeting » et « standard », et clarification des règles concernant les homophones, tels que « hai » vs « ai » et « ha » vs « a ».

Orthographe

  • Des dictionnaires enrichis comprenant plus de 970 nouveaux mots en anglais, allemand, espagnol, portugais et italien, couvrant les abréviations, les affixes, les anglicismes, la biologie, le monde des affaires, les termes courants, l'économie, l'alimentation, le vocabulaire juridique, la linguistique, la géographie, les mesures, la médecine, les néologismes, d'autres langues, les noms propres, la religion, les sciences, la terminologie spécialisée et la technologie.
  • Enrichissement des dictionnaires multilingues partagés avec 170 noms propres et abréviations, tels que XOF, OpenOffice, Eurocontrol, etc.
  • Enrichissement de la terminologie médicale et scientifique en anglais et en espagnol avec 64 nouveaux mots, parmi lesquels des termes tels que « bromobenzoates » et « fCJD » en anglais, et « urotelio » en espagnol.
  • Prise en charge étendue des variantes linguistiques de l'anglais, notamment en matière de terminologie médicale, comme « bunaftine » (américain) et « bunaphtine » (britannique).
  • Correction automatique améliorée avec de nouvelles paires de mots en anglais et en espagnol, ciblant les fautes d'orthographe courantes, telles que « multipanares » → « multiplanares ».

Assistant de rédaction basé sur l'IA

  • Des consignes en anglais améliorées pour des corrections dialectales plus précises lors de la relecture.
  • Mise à jour des instructions dans toutes les langues afin de préserver les emojis lors de l'application de corrections de texte, garantissant ainsi que les émoticônes et les emojis restent inchangés pendant les opérations de relecture.

🛡 Sécurité

  • Mise à jour de Micrometer : Micrometer a été mis à jour de la version 1.15.12 à la version 1.16.7 afin de corriger deux vulnérabilités signalées par Snyk. Cette mise à jour corrige une fuite de mémoire à haut niveau de gravité dans la collecte des métriques, susceptible d'affecter la stabilité du registre. La dépendance d'intégration Prometheus a également été mise à jour vers la version 1.16.7 pour des raisons de compatibilité.
  • Mise à jour de Netty : le module « netty-handler » a été mis à jour, passant de la version 4.1.136.Final à la version 4.1.137.Final, afin de corriger deux vulnérabilités signalées par Snyk. Ces correctifs résolvent un problème de non-correspondance des noms d'hôtes, considéré comme très grave, lors de la validation des certificats, ainsi qu'une faille critique dans la gestion des exceptions. Cette mise à jour profite à tous les utilisateurs qui ont besoin de communications réseau sécurisées.
  • VAPT: mise à jour du rapport v6.17.0

v6.16.0

La version 6.16.0 de WProofreader Core introduit un nouveau système de licence comprenant des autorisations d'utilisation, des limites d'utilisation et des restrictions de version ; elle améliore la fiabilité des corrections grammaticales en anglais, met à jour le moteur grammatical tiers, corrige une faille de sécurité à haut niveau de gravité et enrichit les dictionnaires orthographiques de plus de 1 960 nouveaux mots dans neuf langues.

📝 En bref

  • Mise en place d'un nouveau format de licence v4 comprenant des concessions de produit, des limites d'utilisation et des restrictions de version
  • Les clients en auto-hébergement doivent réactiver leur licence après la mise à jour vers la version 6.16.0 (voir les modifications majeures ci-dessous)
  • Correction d'une faille de sécurité à haut niveau de gravité, CVE-2026-40984, dans une dépendance de LanguageTool
  • Ajout du nouveau license_status commande et amélioration des rapports et des avertissements relatifs à l'expiration des licences
  • Mise à jour du moteur de grammaire tiers (LanguageTool) vers la version du 03/08/2026
  • Des dictionnaires orthographiques enrichis, avec plus de 1 960 nouveaux mots répartis sur neuf langues

⚠️ Changement important pour les clients en auto-hébergement

  • Les clients utilisant une installation auto-hébergée doivent réactiver leur licence après chaque mise à jour de WProofreader, à compter de la version 6.16.0. Cela permet de vérifier que la nouvelle version est conforme aux restrictions de version prévues par la licence. Réactivez votre licence immédiatement après la mise à jour afin d'éviter toute interruption de service. Pour plus d'informations, consultez la documentation relative à l'activation de la licence sous Linux, Windows ou Docker.

🛠 Améliorations

Licences

  • Un nouveau format de licence v4 a été mis en place, prenant en charge les attributions de produits, les limites d'utilisation et les restrictions de version. Les licences définissent désormais directement les droits liés aux produits et l'éligibilité aux mises à niveau.
  • Ajout du nouveau license_status Commande API permettant de récupérer les informations relatives à la licence. Vérification Documents relatifs au statut de la licence pour plus d'informations.
  • Amélioration de l'affichage de la date d'expiration de la licence afin d'indiquer la durée exacte restante en jours, heures, minutes et secondes. Les messages d'état utilisent désormais une formulation plus claire : « La licence expire dans ».
  • Ajout d'un avertissement concernant l'expiration de la licence au cours des 24 dernières heures précédant cette expiration, afin de rappeler une nouvelle fois à l'utilisateur de renouveler sa licence avant toute interruption du service.

Déploiement

  • Il arrivait parfois que les conteneurs Docker ne parviennent pas à activer la licence après un redémarrage avec un nouveau ticket de licence et un fichier license.xml vide. Cela fonctionne désormais correctement, y compris pour les configurations où le répertoire de licence est stocké dans un volume monté.

Grammaire

  • Mise à jour du moteur de grammaire tiers (LanguageTool) vers la version du 03/08/2026.
  • Des règles de grammaire anglaise améliorées, avec des corrections plus claires et moins de faux positifs :
    • Correction d'une suggestion erronée de virgule avant et dans les phrases utilisant l'expression figée « every now and then ».
    • On a cessé de signaler à tort que le mot « pretrain » manquait d'un infinitif, car il peut faire office de nom dans certains textes spécialisés.
    • On a cessé de signaler à tort l'utilisation de « am » dans les phrases où figure un nom ou un titre entre les deux, comme dans « Moi, John Smith, directeur marketing de XXX, je vous écris pour confirmer… »
    • Ajout de recommandations concernant la majuscule et la ponctuation des interjections en début de phrase : ahh enfinAhh, enfin
    • Ajout de suggestions pour ponctuer les phrases commençant par une interjection suivie de « that »: « wow, ça l'a bien échappé » → « Wow, ça l'a bien échappé »

Orthographe

  • Des dictionnaires enrichis comprenant plus de 1 960 nouveaux mots en anglais, allemand, espagnol, arabe, norvégien, italien, albanais, grec et portugais. Ces nouveaux mots couvrent le vocabulaire courant, scientifique et spécialisé.
  • Enrichissement des dictionnaires multilingues partagés avec 26 nouveaux noms propres et abréviations, couvrant des termes issus des domaines du logiciel, du droit, de la médecine et de la technologie, tels que AgentCore, GPLv2 et eSIM.
  • Vocabulaire médical enrichi en anglais, allemand et espagnol, avec plus de 820 nouveaux termes, abréviations et noms de maladies, tels que « cryofixation » (anglais), « Leukozyten » (allemand) et « sonografía » (espagnol).
  • Élargissement de la couverture des variantes linguistiques de l'anglais avec 10 nouvelles paires de mots, telles que « conization » et « conisation ».
  • Amélioration de la correction automatique et des suggestions orthographiques pour l'arabe, le norvégien, l'italien, l'espagnol, l'allemand et l'anglais, en ciblant les fautes d'orthographe courantes et les variantes dialectales, telles que « trøt » → « trøtt » en norvégien.

🛡 Sécurité

  • Mise à jour micrometer-core de la version 1.7.12 à la version 1.15.12 pour corriger CVE-2026-40984, une vulnérabilité de type « déni de service » à haut niveau de gravité affectant les dépendances de LanguageTool incluses dans WProofreader.
  • Je suis également passé à micrometer-registry-prometheus-simpleclient afin de préserver la compatibilité avec l'intégration Prometheus existante.

v6.15.0

WProofreader core v6.15.0 ajoute la prise en charge de la correction orthographique pour le thaï, introduit la applyAllSuggestions méthode permettant d'appliquer toutes les corrections suggérées en une seule opération, et améliore les descriptions des suggestions dans la grammaire et les moteurs de correction basés sur l'IA. Cette version enrichit également les dictionnaires de plus de 1 200 nouveaux mots et termes dans neuf langues, met à jour l'orthographe allemande et inclut des améliorations au niveau de la compilation Docker ainsi que des correctifs pour plusieurs failles de sécurité.

📝 En bref

  • Ajout de la prise en charge de la correction orthographique pour le thaï.
  • A présenté le applyAllSuggestions méthode permettant d'appliquer toutes les corrections suggérées dans un document en un seul appel.
  • Amélioration de la classification des suggestions dans les moteurs de correction grammaticale et d'IA, avec notamment une nouvelle fonctionnalité de détection des problèmes de style.
  • Des dictionnaires enrichis comprenant plus de 1 200 nouveaux mots et termes dans neuf langues.
  • Les suggestions de points manquants sont désormais désactivées par défaut dans les titres et les éléments de liste.
  • Amélioration de la compatibilité des builds Docker entre Kaniko, Buildah et le générateur Docker classique.
  • Corrections de sécurité. Mise à jour des bibliothèques Rangy, jackson-databind et ch.qos.logback pour corriger la vulnérabilité CVE-2023-26102, CVE-2026-54515, CVE-2026-9828, et CVE-2026-10532.

Noyau WProofreader JS (v3.44.6097)

  • Ajout d'un nouveau applyAllSuggestions commande qui accepte toutes les corrections suggérées en une seule fois, au lieu de les appliquer une par une. Elle est d'ores et déjà disponible pour que les développeurs puissent l'intégrer à leur configuration ; un bouton prêt à l'emploi dans l'interface sera disponible dans une prochaine version.
  • Les rappels de règles manquantes n'apparaissent plus par défaut dans les titres et les éléments de liste, ce qui réduit le nombre de suggestions qui ne s'appliquent pas dans ces contextes. Vérifier disabledRulesPerEnvironment dans le documentation relative à la configuration Pour plus d'informations.
  • Amélioration de la reconnaissance des abréviations allemandes comportant des espaces et des majuscules (telles que « z. B. ») : celles-ci ne déclenchent désormais plus de suggestions de majuscules erronées après leur apparition.
  • Amélioration du fonctionnement de l'option « Ignorer les noms de domaine ». Les noms de domaine sont désormais systématiquement ignorés, même dans les cas où ils étaient auparavant encore signalés comme des fautes d'orthographe. Pour plus de détails, consultez la documentation relative aux options d'ignorance orthographique.

Serveur d'applications

  • Les messages obsolètes relatifs à la validation du matériel ont été supprimés des journaux du serveur d'applications. Le matériel n'est plus utilisé pour la validation des licences depuis un certain temps, mais les messages correspondants subsistaient et pouvaient prêter à confusion lors du dépannage.

Déploiement

  • Amélioration de la fiabilité des builds Docker avec Kaniko, Buildah et le générateur Docker classique, y compris pour les configurations qui remplacent les valeurs à l'aide de --build-arg. Les arguments de compilation sont désormais correctement transmis à chaque étape d'un processus de compilation en plusieurs étapes, ce qui corrige les cas où les étapes suivantes ne pouvaient pas les prendre en compte.

Relecture assistée par l'IA

  • Les suggestions relatives aux tirets proposées par le moteur de correction automatique basé sur l'IA sont désormais plus faciles à identifier et à désactiver, ce qui s'avère utile si votre guide de style impose des restrictions concernant l'utilisation des tirets ou recommande de les éviter. Pour plus d'informations sur les règles, consultez les informations relatives aux catégories et aux règles de correction automatique en anglais.
  • Outre l'orthographe et la grammaire, les suggestions de correction proposées par l'IA peuvent désormais être classées en tant que problèmes de style, ce qui permet de les identifier avec plus de précision. Consultez les catégories et les règles de style relatives à la correction automatique en anglais.
  • Ajout de descriptions détaillées pour les corrections apportées par l'IA lors de la relecture en anglais. Notre équipe linguistique a rédigé ces descriptions afin de permettre de mieux comprendre les raisons qui ont motivé chaque suggestion.

Grammaire

  • Les suggestions provenant du moteur de grammaire tiers sont désormais correctement classées en problèmes de grammaire, d'orthographe ou de style, ce qui permet de les mettre en évidence de manière appropriée. Auparavant, toutes les suggestions issues de ce moteur apparaissaient comme des problèmes de grammaire, même lorsqu'il n'en était rien.
  • Mise à jour de LanguageTool vers la version du 14 juillet 2026.
  • Amélioration de la reconnaissance des mots allemands pouvant être utilisés à la fois comme verbe et comme adjectif, tels que « strukturierte ». Auparavant, certains d'entre eux n'étaient reconnus que comme verbe, ce qui pouvait amener l'algorithme de détection des virgules à mal interpréter la structure de la phrase et à suggérer à tort de supprimer une virgule valide.
  • La cohérence entre les noms des règles a été améliorée : désormais, l'activation ou la désactivation d'une règle de grammaire spécifique s'applique de la même manière, quel que soit le moteur de vérification qui la traite.

Orthographe

  • Le néerlandais reconnaît désormais comme correctement orthographiés les mots comportant des apostrophes, tels que ‘s-Hertogenbosch.
  • Amélioration des suggestions orthographiques pour les abréviations allemandes qui nécessitent un espace entre leurs deux parties, par exemple en corrigeant « z.B. » en « z. B. ».
  • Plus de 640 nouveaux mots et termes ont été ajoutés en anglais, allemand, espagnol, ukrainien, bulgare, néerlandais, thaï, grec et portugais. Ils couvrent aussi bien le vocabulaire courant que des domaines spécialisés tels que les sciences, les affaires et la technologie.
  • Le dictionnaire multilingue partagé a été enrichi de plus de 30 nouveaux noms propres et abréviations, notamment des noms d'entreprises, de produits et d'organisations, tels que Canon, Ltd et Rakuten. De plus, il a été ajouté en tant que dictionnaire supplémentaire pour la vérification orthographique du grec.
  • Ajout de 550 nouveaux termes médicaux en anglais, allemand et espagnol, y compris des abréviations et des noms de procédures, tels que « hepatoscopy », « Unkovertebralgelenke » et « USG ».
  • Prise en charge étendue des variantes de l'anglais avec 17 nouvelles paires de variantes, telles que « hematoporphyrin » (américain) et « haematoporphyrin » (britannique).
  • Amélioration de plus de 40 suggestions d'orthographe et de correction automatique en anglais, espagnol, ukrainien, bulgare, catalan et dans le dictionnaire multilingue commun. Ces améliorations ciblent les fautes d'orthographe courantes, les noms propres et les abréviations, telles que « llm » → « LLM ».

Saisie semi-automatique

  • La fonction de saisie semi-automatique interrompt désormais toute suggestion lorsque le texte saisi contient des mots pouvant être considérés comme des jurons grossiers.

Langues

  • Prise en charge de la correction orthographique en thaï.

🛡 Sécurité

  • Bibliothèque Rangy: nous avons intégré le correctif en amont concernant la vulnérabilité CVE-2023-26102 dans notre fork de la bibliothèque Rangy utilisée dans SCAYT3, ce qui a permis de corriger la vulnérabilité tout en préservant la compatibilité avec notre fork.
  • jackson-databind: Nous avons mis à jour jackson-databind vers la version 2.18.9 afin de corriger la vulnérabilité CVE-2026-54515. Cette mise à jour concerne les composants qui dépendent de jackson-databind, que ce soit directement ou de manière transitive.
  • ch.qos.logback: Nous avons mis à jour ch.qos.logback, passant de la version 1.5.25 à la version 1.5.35, afin de corriger deux vulnérabilités liées à la désérialisation, CVE-2026-9828 et CVE-2026-10532. Cette mise à jour concerne les composants qui dépendent de ch.qos.logback, que ce soit directement ou de manière transitive.

🐞 Corrections de bugs

  • Moteur d'orthographe : les mots allongés, tels que « loooooooooooong », n'ont donné lieu à aucune suggestion.
  • Moteur d'orthographe : des chaînes de lettres incompréhensibles, telles que « fjkdkdjshkhfdk », ont généré des suggestions de mots réels sans rapport avec le texte.

v6.14.0

WProofreader Core v6.14.0 lance la version 3.1.0 de son moteur de correction basé sur l'IA pour l'espagnol, étend la prise en charge de l'assistant de rédaction basé sur l'IA au grec, améliore le comptage multilingue des mots, élargit la couverture des dictionnaires avec plus de 7 800 nouveaux mots, optimise la validation des dictionnaires personnalisés et la gestion des apostrophes, et inclut des mises à jour de sécurité pour les dépendances Jackson.

📝 En bref

  • Lancement de la version 3.1.0 du moteur de correction basé sur l'IA pour l'espagnol, offrant une qualité de correction améliorée en matière de grammaire, d'usage des mots, de formes verbales, de prépositions, d'orthographe des nombres et de confusions courantes entre mots.
  • Ajout de la prise en charge du grec dans l'assistant de rédaction IA
  • Assistant de rédaction en espagnol basé sur l'IA optimisé grâce à la migration depuis les modèles d'Anthropic
  • Des dictionnaires enrichis comprenant plus de 2 700 nouveaux mots dans plusieurs langues, notamment des abréviations, des noms propres, des termes techniques et des termes linguistiques
  • Amélioration du comptage et du traitement des mots pour plusieurs langues, notamment le japonais et le chinois
  • Ajout de la prise en charge des tirets dans les noms de dictionnaires et amélioration de la gestion des apostrophes dans les dictionnaires personnalisés et les dictionnaires utilisateur
  • Mise à jour de LanguageTool vers la version du 12 juin 2026
  • Amélioration de la couverture du dictionnaire danois et néo-zélandais
  • Mises à jour de sécurité. Mise à jour de jackson-core et jackson-databind pour corriger les vulnérabilités CWE-770 et CVE-2026-54513

⚠️ Changement important

  • Amélioration du comptage des mots pour plusieurs langues, y compris celles qui n'utilisent pas d'espaces. Auparavant, les mots étaient identifiés à l'aide des espaces et de la ponctuation, ce qui faisait que des phrases entières dans des langues telles que le japonais et le chinois étaient comptées comme un seul mot. WProofreader utilise désormais une segmentation basée sur ICU pour compter les morphèmes dans ces langues, ce qui permet d'obtenir des comptages de mots et des statistiques linguistiques plus précis. Par exemple, わかんない est désormais compté comme 3 morphèmes (わか / ん / ない), au lieu d'un seul.

🛠 Améliorations

Noyau WProofreader JS (v3.43.6079)

  • Ajout d'une version en grec de la clause de non-responsabilité relative à l'assistant de rédaction basé sur l'IA.
  • Mise à jour de la validation des mots du dictionnaire utilisateur et du dictionnaire personnalisé afin de prendre en charge tous les caractères d'apostrophe autorisés.

Relecture assistée par l'IA

  • Lancement de la version 3.1.0 du moteur de correction basé sur l'IA pour l'espagnol. Amélioration de la qualité des corrections concernant le subjonctif, les temps verbaux, les verbes pronominaux, les prépositions, l'accord des adjectifs et des adverbes, l'accord des participes passés, les constructions partitives, l'orthographe des nombres et les confusions courantes entre certains mots, notamment « ser » et « haber ». Consultez la documentation pour plus de détails sur les améliorations apportées à la correction en espagnol.
  • Amélioration des performances de correction automatique basée sur l'IA, toutes langues confondues, pour les textes comportant des indices et des exposants.

Grammaire

  • Mise à jour de LanguageTool vers la version du 12 juin 2026.

Assistant de rédaction basé sur l'IA

Orthographe

  • Des dictionnaires enrichis comprenant plus de 2 700 nouveaux mots en anglais, allemand, espagnol, ukrainien, danois et portugais, couvrant les abréviations, les termes techniques, les mots courants, les noms propres et les termes linguistiques. 
  • Les dictionnaires allemands ont également été enrichis de plus de 4 600 nouvelles formes nominales comportant un « -s » de liaison et de formes combinées avec un trait d'union, telles que « Fort- ». 
  • Terminologie médicale enrichie pour l'anglais, l'allemand et l'espagnol, avec 495 nouveaux termes, couvrant les adjectifs médicaux, les noms de maladies et les abréviations, tels que « palmitoylcarnitine », « test de Finkelstein » et « distrófica ».
  • Amélioration de la couverture dialectale de l'anglais grâce à de nouvelles paires de mots, telles que « preprosthetic » et « pre-prosthetic ». 
  • Amélioration du traitement de texte en allemand grâce à l'autorisation des traits d'union en début de mot, tout en limitant l'utilisation des deux-points au sein des mots, comme dans « -konzepte ».
  • Règles d'orthographe et de correction automatique affinées pour les fautes d'orthographe courantes et phonétiques en anglais et en espagnol, telles que « Afroasiatic » → « Afro-Asiatic ».

Dictionnaires personnalisés et dictionnaires utilisateur

  • Amélioration de la validation des noms de dictionnaires utilisateur. Les noms de dictionnaires prennent désormais en charge les tirets et acceptent les lettres latines ASCII, les chiffres, les traits de soulignement et les tirets. Les règles de validation et les messages d'erreur ont été mis à jour afin d'assurer une gestion plus cohérente des noms non valides.
  • Les dictionnaires personnalisés et les dictionnaires utilisateur prennent désormais en charge l'ajout de mots comportant différents types d'apostrophes, tels que « l’acqua », « l’acqua », etc .

Style

  • Poursuite de l'amélioration du filtrage des suggestions de saisie semi-automatique contenant des termes sensibles, inattendus ou discriminatoires.
  • Ajout de la prise en charge des suggestions de style et des modèles commençant par un espace, comme en allemand*in → (m/f/d), afin de disposer d'un modèle unique pour Arzt*inArzt (m/f/d) et Professor*in → Professor (m/f/d).

Langues

🛡 Sécurité

  • Mise à jour de jackson-core : mise à jour de jackson-core vers la version 2.18.7 pour corriger CWE-770. Portée : composants dépendant de jackson-core (directement ou de manière transitive) dans les paquets langtool/libs.
  • Mise à jour de jackson-databind : mise à jour de jackson-databind vers la version 2.18.8 pour corriger la vulnérabilité CVE-2026-54513. Portée : composants dépendant de jackson-databind (de manière directe ou transitive) dans le paquetage langtool/libs.

🐞 Corrections de bugs

  • Noyau de WProofreader JS : des puces noires inattendues apparaissent dans l'interface utilisateur de WProofreader (WordPress 7.0, plugin Guttenberg). Résolution d'un conflit de style qui entraînait l'affichage des puces par défaut dans les composants de l'interface de WProofreader.

v6.13.1

La version 6.13.1 du noyau de WProofreader améliore la compatibilité avec les éditeurs hébergés dans des conteneurs Shadow DOM en corrigeant la détection automatique des éditeurs, leur initialisation et la fonctionnalité de recherche automatique ; elle renforce la sécurité de l'image Docker de WProofreader grâce à des correctifs de vulnérabilités dans OpenNLP et Netty ; et met à jour le rapport VAPT.

📝 En bref

  • Compatibilité améliorée avec les éditeurs hébergés dans des conteneurs Shadow DOM, notamment la détection automatique des éditeurs, leur initialisation et le chargement des styles
  • Correction du fonctionnement de la recherche automatique dans les environnements Shadow DOM
  • Mise à jour des composants OpenNLP et Netty dans l'image Docker de WProofreader afin de corriger sept vulnérabilités signalées
  • Mise à jour du rapport VAPT vers la version 6.13.1 et amélioration de la conformité du scanner de vulnérabilités

🛠 Améliorations

Noyau WProofreader JS (v3.42.6067)

  • Prise en charge améliorée du Shadow DOM. Correction de la détection automatique des éditeurs et de l'initialisation du correcteur pour les éléments modifiables hébergés dans des conteneurs Shadow DOM. WProofreader détecte désormais correctement les éditeurs actifs, conserve les instances lorsque les éditeurs restent connectés à la page et charge les styles d'interface utilisateur et de balisage requis au sein des environnements Shadow DOM. 

🛡 Sécurité

  • Corrections de sécurité OpenNLP : intégration d'une version corrigée d'OpenNLP 1.9.4 comprenant des correctifs rétroportés pour les vulnérabilités CVE-2026-40682, CVE-2026-42027 et CVE-2026-42440, tout en préservant la compatibilité avec LanguageTool et en corrigeant les vulnérabilités signalées. Portée : composants OpenNLP utilisés de manière transitive par LanguageTool et inclus dans l'image Docker de WProofreader. 
  • Mise à jour de Netty : la version de Netty incluse dans le package a été mise à jour de 4.1.133.Final à 4.1.135.Final afin de corriger les vulnérabilités« » CVE-2026-44249, CVE-2026-45416, CVE-2026-45674 et CVE-2026-47691. Portée : composants Netty utilisés de manière transitive par LanguageTool et intégrés dans l’image Docker de WProofreader.
  • VAPT: Mise à jour du rapport v6.13.1

v6.13.0

La version 6.13.0 de WProofreader Core migre les fonctionnalités de l'assistant de rédaction basé sur l'IA vers de nouveaux modèles et rétablit la prise en charge de Google Docs ; elle améliore la qualité de la correction et de la saisie semi-automatique basées sur l'IA, enrichit les dictionnaires multilingues de plus de 1 400 mots, instaure des limites pour les dictionnaires personnalisés et les collections de guides de style, met à jour les dictionnaires ukrainien et finnois, et propose une mise à jour de sécurité.

📝 En bref

  • Migration des modèles d'assistants de rédaction basés sur l'IA vers des solutions alternatives proposées par Amazon et Google, dans le cadre de l'abandon des modèles Anthropic Claude et afin d'optimiser les performances
  • Mise à jour des dictionnaires ukrainien et finnois 
  • Des dictionnaires enrichis comprenant plus de 1 400 nouveaux mots en anglais, allemand, espagnol et portugais, avec des mots courants, de la terminologie médicale, des noms propres supplémentaires et des abréviations
  • Amélioration de la qualité orthographique grâce à une meilleure prise en charge des mots grecs en majuscules
  • Amélioration du filtrage des suggestions de saisie semi-automatique contenant des termes sensibles ou discriminatoires
  • Mise à jour du guide de style avec les nouvelles règles concernant les anglicismes en espagnol
  • Amélioration de la qualité de la relecture par IA sur l'ensemble des modèles pris en charge et optimisation de la relecture par IA en espagnol (v3.0) pour des corrections plus fiables.
  • La compatibilité de l'assistant de rédaction basé sur l'IA avec Google Docs a été rétablie
  • Mise à jour de sécurité. Mise à jour d'OpenTelemetry pour corriger la vulnérabilité CVE-2026-45292

🛠 Améliorations

Noyau WProofreader JS (v3.42.6057)

  • Amélioration de la compatibilité avec Google Docs. Correction des problèmes qui empêchaient l'assistant de rédaction IA de fonctionner correctement dans Google Docs.

Relecture par IA

  • Amélioration de la qualité de la relecture par IA en anglais, allemand et espagnol en matière de ponctuation et de gestion des espaces, notamment en ce qui concerne les virgules décimales, les tirets courts et la ponctuation autour du texte corrigé.
  • Amélioration de la précision de la correction en espagnol grâce à la suppression des pronoms redondants, des signes de ponctuation superflus, des symboles de degré, des crochets et des suggestions en double.
  • Amélioration de la qualité des suggestions en allemand grâce à une limitation de la suppression de mots à la fin des phrases allemandes.

Assistant de rédaction basé sur l'IA

  • L'assistant de rédaction basé sur l'IA « Claude Haiku 3 » d'Anthropic a été migré suite à sa dépréciation. Pour plus d'informations, consultez la documentation relative aux modèles anglais actuels.
  • Nous avons migré certains workflows d'assistants de rédaction basés sur l'IA en norvégien, italien, espagnol et danois depuis Anthropic Claude Sonnet 4, suite à la fin de prise en charge de ce dernier.
  • Mise à jour des prompts et migration de l'assistant de rédaction IA allemand et ukrainien depuis Anthropic Claude Haiku 4.5 afin d'améliorer ses performances.
  • Amélioration des suggestions de l'assistant de rédaction basé sur l'IA en néerlandais, suédois, portugais et polonais, pour des résultats plus cohérents en matière de réécriture, d'ajustement du ton, de raccourcissement et de développement.

Orthographe

  • Amélioration de la gestion des mots en majuscules en grec, tels que ΕΙΔΗΣΗ.
  • Des dictionnaires enrichis comprenant plus de 1 000 nouveaux mots en anglais, allemand, espagnol et portugais, couvrant les abréviations, les affixes, la biologie, les mots courants, les variations dialectales, la gastronomie, la linguistique, la musique, les noms propres, l'argot et la technologie.
  • Enrichissement des dictionnaires multilingues partagés avec plus de 30 noms propres et abréviations, tels que « Googlebot » et « ISO ».
  • Terminologie médicale enrichie en anglais et en espagnol, avec 471 nouveaux mots couvrant les termes médicaux, la terminologie juridique, les abréviations et le vocabulaire associé.
  • Couverture élargie des dialectes anglais grâce à l'ajout de nouvelles paires de mots dialectaux, telles que « radiolabeled » et « radiolabelled ».
  • Règles de suggestion affinées pour les fautes d'orthographe courantes en anglais et en espagnol, telles que « gritings » → « greetings ».

Dictionnaire personnalisé

  • Ajout d'une limite du nombre de dictionnaires personnalisés en fonction de la formule d'abonnement. Jusqu'à 250 pour les installations auto-hébergées.

Style

  • Une limite a été ajoutée concernant le nombre de collections de guides de style, en fonction du forfait d'abonnement. Jusqu'à 250 pour l'hébergement autonome.
  • Le paramètre « collection » est désormais obligatoire pour toutes les actions impliquant des règles du guide de style via l'API
  • Mise à jour du guide de style espagnol avec de nouvelles règles concernant les anglicismes, tels que « download », « shopping center », etc.
  • Ajout de la possibilité d'utiliser une partie du champ « modèle » dans le champ « suggestion ». Par exemple : Lehrer → Lehrer*in

Saisie semi-automatique

  • Amélioration du filtrage des suggestions de saisie semi-automatique contenant des termes sensibles, inattendus ou discriminatoires, tels que « guerre », « drogue », etc.

Langues

  • Mise à jour du dictionnaire Hunspell en ukrainien (uk_UA) vers la version 6.8.0 (23 avril 2026) par Rysin, A. et Starko, V., qui comprend une extension du dictionnaire avec plus de 12 000 entrées. Source : https://github.com/brown-uk/dict_uk/releases#release-v6.8.0 
  • Le dictionnaire Hunspell en finnois (fi_FI) a été mis à jour vers la version 0.2 (6 décembre 2023) par Voiko, ce qui a considérablement élargi la couverture lexicale dans les domaines technique et médical, ainsi qu’au niveau des noms propres. Source : https://github.com/fginter/hunspell-fi/releases/tag/0.2 

🛡 Sécurité

  • Mise à jour d'OpenTelemetry : mise à jour d'OpenTelemetry vers la version 1.62.0 pour corriger la vulnérabilité CVE-2026-45292. Portée : composants dépendant d'opentelemetry (directement ou par transitivité) dans les paquets langtool/libs.

🐞 Corrections de bugs

  • Noyau de WProofreader JS : l'assistant de rédaction basé sur l'IA ne fonctionne pas dans Google Docs
  • L'assistant de rédaction basé sur l'IA a cessé de fonctionner pour l'extension gratuite permettant la détection automatique de la langue

v6.11.0

Sortie de la version v6.11.0 du noyau de WProofreader

WProofreader v6.11.0 simplifie le déploiement en auto-hébergement en supprimant les exigences relatives au nom de domaine, introduit de nouvelles options JS de base pour les mises en page adaptatives et le contrôle des badges RTL, et remplace le kit de vérification par défaut en anglais par ai_lt_hs1, destiné aux utilisateurs du cloud, enrichit les dictionnaires de plus de 9 700 nouvelles entrées, met à jour le moteur grammatical avec des améliorations majeures pour le catalan et corrige une faille de sécurité.

Consultez le résumé ci-dessous.

📝 En bref

  • [Cloud] La configuration par défaut de la vérification du texte en anglais a été modifiée comme suit : ai_lt_hs1. Associe le moteur de relecture basé sur l'IA aux moteurs algorithmiques de grammaire et d'orthographe pour une précision accrue
  • L'installation en auto-hébergement ne nécessite plus de nom de domaine — configuration simplifiée pour Docker, Windows et Linux
  • Nouvelles options « enableScale » et « disableBadgeRTLMirroring » dans le noyau de WProofreader JS
  • Des dictionnaires enrichis comprenant plus de 9 700 nouvelles entrées en anglais, allemand, espagnol, ukrainien et russe
  • Dictionnaire allemand enrichi comprenant plus de 13 550 formes de mots composés pour les noms féminins se terminant par « Fuge-s »
  • Mise à jour du moteur de grammaire tiers, avec des améliorations majeures pour le catalan et des affinements des règles pour l'allemand, l'espagnol, le portugais, l'ukrainien et l'anglais
  • Les dictionnaires personnalisés acceptent désormais les mots qui figurent déjà dans les dictionnaires d'orthographe par défaut.
  • Correctif de sécurité. Mise à jour de jackson-core pour corriger la vulnérabilité GHSA-72hv-8253-57qq

🛠 Améliorations

Noyau WProofreader JS (v3.39.6037)

  • Ajout d'une nouvelle option « enableScale ». Elle active la prise en charge des transformations d'échelle CSS appliquées aux éléments parents. Lorsqu'elle est activée, WProofreader détecte la valeur d'échelle de l'élément parent et ajuste les éléments de l'interface utilisateur en conséquence, garantissant ainsi que la mise en évidence et les éléments de l'interface restent correctement alignés lorsque le contenu environnant est redimensionné. Désactivée par défaut.
  • Ajout d'une nouvelle option « disableBadgeRTLMirroring ». Elle désactive la mise en miroir automatique de la position des badges pour les langues s'écrivant de droite à gauche (RTL), telles que l'arabe. Lorsqu'elle est activée, le badge conserve la position qui lui a été attribuée au lieu d'être automatiquement mis en miroir en fonction du sens d'écriture. Les options de positionnement manuel des badges restent inchangées. Cette option est désactivée par défaut.

Déploiement

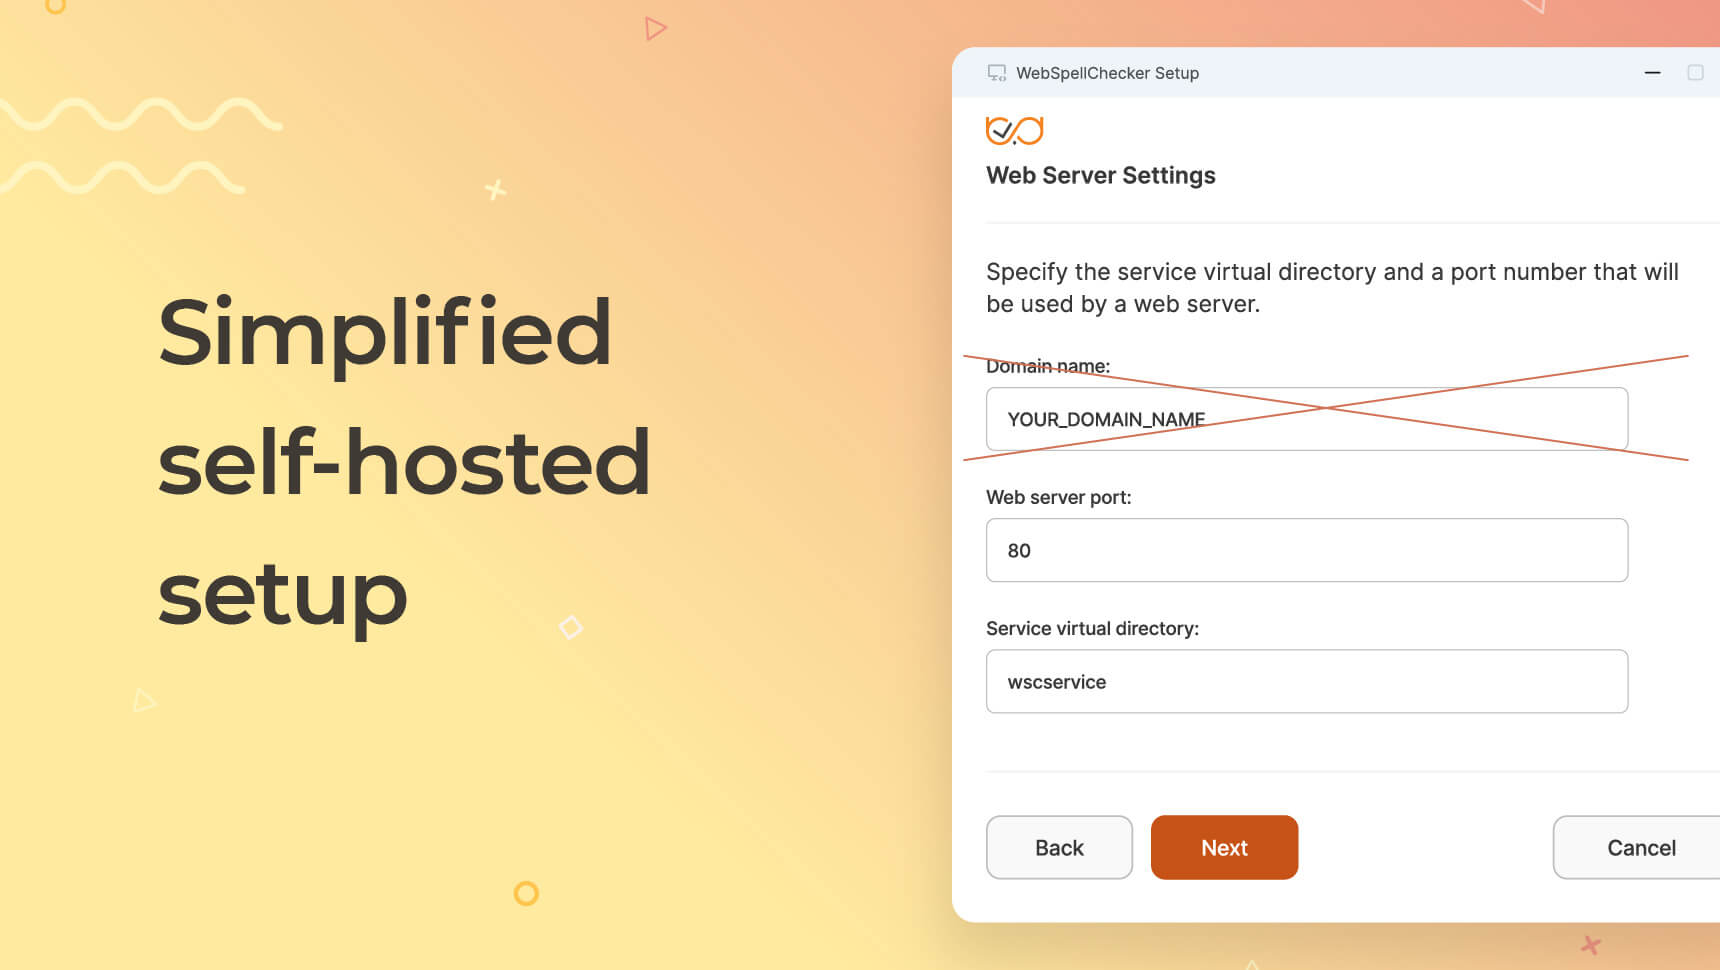
  • La nécessité de spécifier un nom de domaine lors de l'installation de la version auto-hébergée a été supprimée. Cela simplifie la configuration initiale dans les environnements Docker, Windows et Linux :
    • Docker. Suppression du WPR_DOMAIN_NAME paramètre. Ajout de la prise en charge de l'exécution du conteneur à partir du chemin racine (/) via WPR_VIRTUAL_DIR. En savoir plus sur le Configuration de Docker.
    • Tableau Helm. Mise à jour vers la version 1.3.1. Possibilité de définir une valeur vide virtualDir (/), supprimé WPR_DOMAIN_NAME tiré de la extraEnv exemple, et mis à jour appVersion à 6.11.0.0. En savoir plus sur le Carte de navigation.
    • Programmes d'installation pour Windows et Linux. Le serveur web écoute désormais sur n'importe quel domaine par défaut, ce qui supprime une étape courante de la configuration.

Serveur d'applications

  • [Cloud] Modification de la configuration par défaut de la vérification orthographique pour l'anglais afin qu'elle soit ai_lt_hs1. Cette configuration associe le moteur de relecture basé sur l'IA au moteur grammatical algorithmique (LanguageTool) et au moteur orthographique algorithmique (Hunspell), avec des suggestions orthographiques pour une précision accrue. Auparavant, la configuration par défaut (ai_lt_hs0) intégrait Hunspell pour la détection des erreurs, mais sans propositions orthographiques. Si nécessaire, il est possible de rétablir le comportement précédent en configurant le checkKit option permettant de ai_lt_hs0.
  • Amélioration de la journalisation des erreurs. Le serveur d'applications affiche désormais des messages plus détaillés lorsque le chargement des dictionnaires Hunspell échoue, lorsqu'un modèle linguistique d'IA est manquant ou lorsqu'un modèle n-gram n'est pas trouvé. Cela facilite le diagnostic des problèmes de configuration lors du déploiement.
  • Ajout de la possibilité de configurer la longueur maximale des séquences dans la configuration du modèle d'IA.
  • Amélioration de la gestion des chemins d'accès aux fichiers au niveau du serveur d'applications afin d'utiliser des chemins absolus plutôt que d'effectuer une recherche dans le répertoire de travail actuel. Cela permet de résoudre les problèmes rencontrés lorsque le serveur d'applications s'exécute en tant que service systemd sous Linux.

Grammaire

  • Mise à jour du moteur de grammaire tiers avec des améliorations dans plusieurs langues.
    • Catalan. Mise à jour majeure comprenant un nouveau système de reconnaissance des noms propres qui réduit les fausses erreurs d'orthographe pour les noms déjà rencontrés dans le texte, des suggestions améliorées de remplacement de verbes avec une meilleure gestion des pronoms, un nouveau dictionnaire orthographique multi-token pour de meilleures suggestions orthographiques sur plusieurs mots, la prise en charge des constructions causales (al no + infinitifcom que…), la mise à jour du dictionnaire POS catalan vers la version 3.3, l'enrichissement des dictionnaires orthographiques et multi-mots, l'amélioration de la segmentation des phrases grâce à l'abréviation « fund. abréviation pour le catalan et l’espagnol, ainsi que diverses améliorations des règles de désambiguïsation.
    • Allemand. Amélioration des règles grammaticales relatives à la construction « nach zu geben » et ajout de règles pour la gestion du formatage des nombres en allemand avec des séparateurs sous forme de points (par exemple, 100.000).
    • Espagnol. Ajout d'un anti-modèle pour « volares » utilisé comme adjectif afin d'éviter les suggestions erronées au subjonctif.
    • Portugais. Améliorations significatives en matière de désambiguïsation, notamment une meilleure prise en charge des mots « pela » et « pelas » en tant que prépositions, un affinement de la désambiguïsation entre verbes et noms/adjectifs, un nouveau balisage basé sur le contexte pour les catégories sémantiques, l'activation de la règle relative à la virgule redondante après un tiret, l'élargissement des règles concernant les mots pouvant prêter à confusion, l'ajout d'anti-modèles pour les références au mont K2 et au Samsung Galaxy, ainsi que diverses améliorations des règles de style pour le portugais brésilien.
    • Ukrainien. Mise à jour du dictionnaire morphologique vers la version 6.7.5, extension de la prise en charge des abréviations (par exemple : крим, пом, суч), amélioration des modèles de segmentation lexicale, ajout de nombreuses suggestions de remplacement souple, extension des règles de dérivation et amélioration de la désambiguïsation pour le cas vocatif et d'autres constructions grammaticales.
    • Anglais. Ajout des termes « misgendered », « misgender », « misgenders » et « misgendering » au dictionnaire orthographique et amélioration de la gestion des préfixes dans les suggestions orthographiques.

Orthographe

  • Des dictionnaires enrichis comprenant plus de 9 700 nouvelles entrées en anglais, allemand, espagnol, ukrainien et russe, couvrant les abréviations, les affixes, la biologie, la chimie, les termes courants, les variations dialectales, le domaine médical, le domaine militaire, les néologismes, les noms propres, la technologie, et bien plus encore.
  • Le dictionnaire allemand a été enrichi de plus de 13 550 formes de mots composés se terminant par «-Fuge-s » pour les noms féminins associés à un trait d'union (par exemple, « Präventions- »).
  • Enrichissement des dictionnaires multilingues communs avec 125 nouveaux noms propres et abréviations courants.
  • Ajout de nouvelles ressources en russe.
  • Nous avons affiné les listes de mots en supprimant plus de 500 entrées invalides ou incorrectes en anglais, en espagnol et en allemand, en ciblant les mots inexistants, les termes médicaux erronés, les abréviations et les formes en majuscules non valides, ainsi que les entrées non dialectales.
  • Modèles de coupure optimisés grâce à 20 nouvelles règles pour l'anglais et l'espagnol, couvrant les verbes pronominaux, les mots courants, les pronoms et les adverbes, afin d'éviter toute coupure incorrecte des mots. Amélioration de la qualité des suggestions grâce à l'exclusion des termes offensants dans certains contextes et à la suppression des suggestions non valides dans plusieurs catégories.
  • Terminologie médicale enrichie pour l'anglais et l'espagnol, avec plus de 255 nouvelles entrées couvrant les termes latins, les adjectifs médicaux, les noms de maladies et les abréviations. Listes de termes médicaux affinées grâce à la suppression de plus de 230 entrées erronées, notamment des mots incorrects, des formes d'abréviation et des formes en majuscules.
  • Ajout de la prise en charge de deux types d'apostrophes en catalan (U+2019 et U+0027).

Correction automatique

  • Règles de hiérarchisation affinées pour les fautes d'orthographe courantes en anglais et en espagnol. Hiérarchisation améliorée dans le dictionnaire multilingue partagé.
  • Amélioration de la logique de correction grâce à la suppression des entrées de correction automatique erronées en anglais et en espagnol, afin d'éviter les suggestions incorrectes.

Style

  • Mise à jour des règles stylistiques pour l'anglais, avec l'ajout de nouvelles dispositions concernant les propos injurieux et les insultes à caractère racial ou ethnique.

Dictionnaire personnalisé

  • À partir de la version 6.11.0, les mots figurant dans les dictionnaires d'orthographe par défaut peuvent également être ajoutés aux dictionnaires personnalisés des utilisateurs.

🛡 Sécurité

  • La bibliothèque « jackson-core » (utilisée par le moteur de grammaire), qui présentait une vulnérabilité, a été mise à jour vers la version 2.18.6 afin de corriger la vulnérabilité GHSA-72hv-8253-57qq (contournement de la contrainte de longueur des nombres dans l'analyseur JSON asynchrone, pouvant entraîner une situation potentielle de déni de service).

🐞 Corrections de bugs

  • Noyau WProofreader JS : les suggestions mises en évidence se décalent lorsque le plugin Zoom est utilisé dans CKEditor
  • Noyau WProofreader JS : comportement irrégulier de la navigation au clavier dans la boîte de dialogue de l'assistant de rédaction IA dans les environnements mixtes allant de gauche à droite et de droite à gauche
  • Moteur de vérification orthographique : les mots écrits avec des apostrophes typographiques ne sont pas reconnus comme corrects en catalan.
  • Moteur d'orthographe : les règles de division contenant des chiffres ne sont pas autorisées
  • Serveur d'applications : la fonctionnalité des règles autorisées ne fonctionne pas comme prévu
  • Serveur d'applications : Hunspell échoue si le modèle n-gram n'est pas trouvé
  • Guide de style : les règles fondamentales du guide de style ne sont pas consultables
  • Guide de style : les chemins d'accès relatifs sont utilisés pour les fichiers du guide de style

v6.10.0

La version 6.10.0 de WProofreader apporte une amélioration majeure au classement des suggestions orthographiques grâce à un système de priorisation des n-grammes basé sur les trigrammes pour l'anglais, l'allemand et l'espagnol ; elle ajoute des suggestions de saisie automatique au clavier, met à jour le moteur de grammaire, étend la prise en charge linguistique avec des ressources en grec et en tchèque, et corrige une faille de sécurité.

Consultez le résumé ci-dessous.

📝 En bref

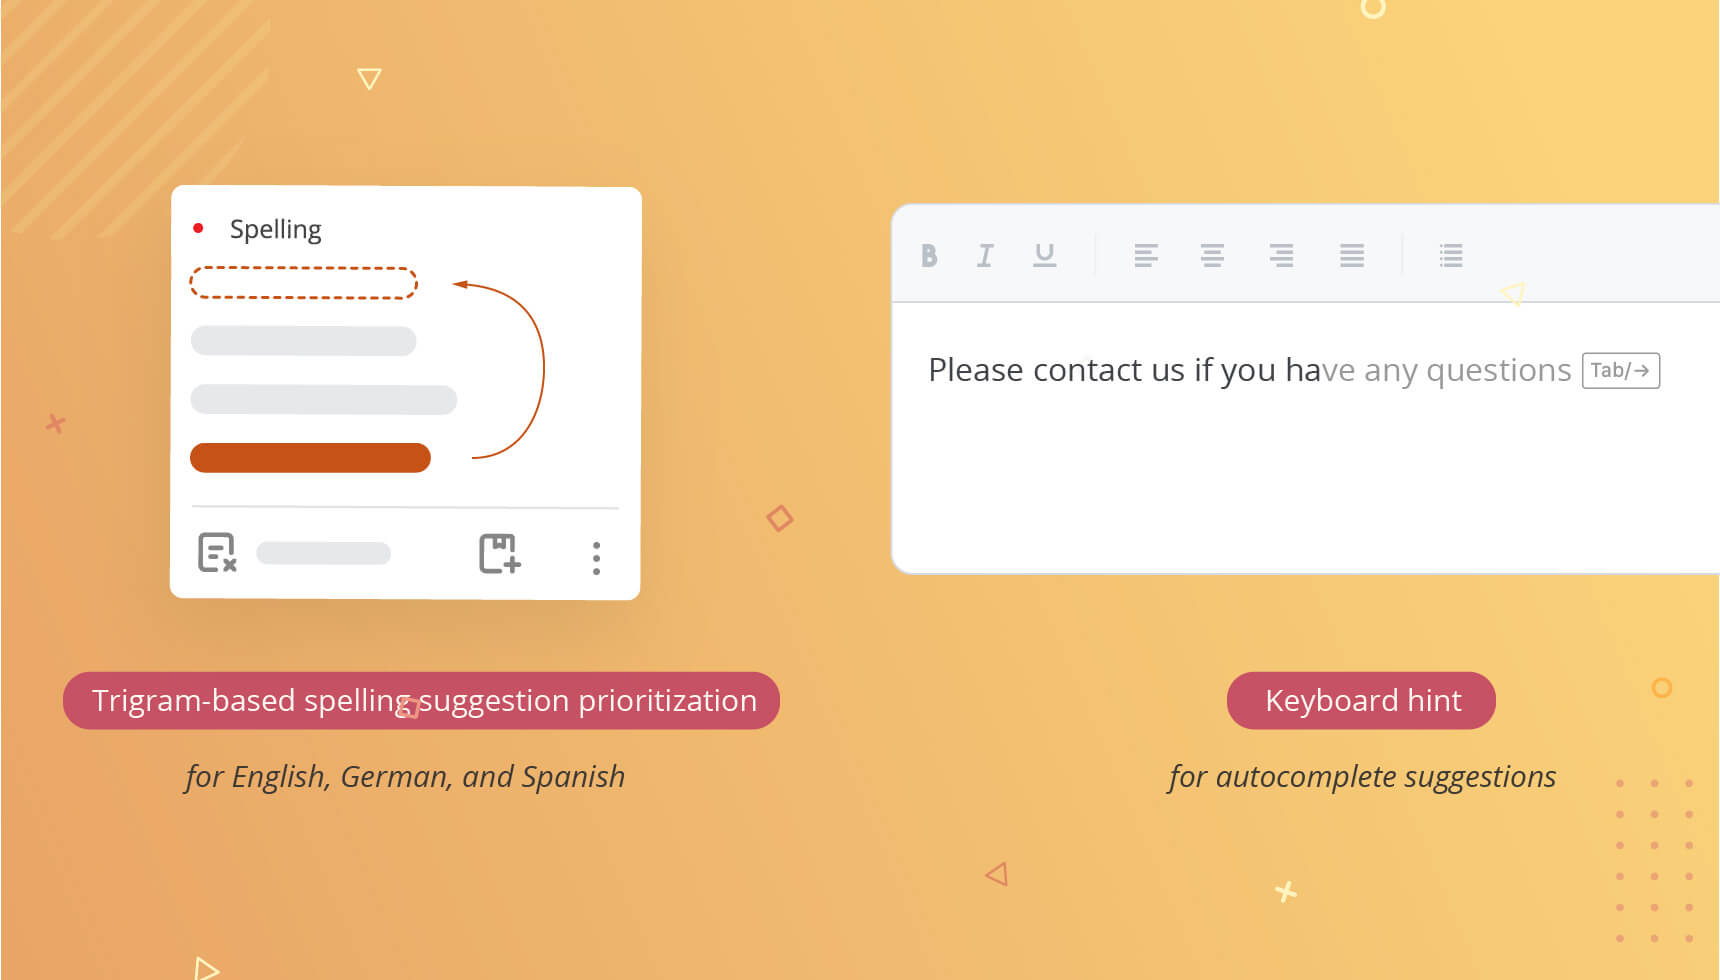
  • Nouveau système de hiérarchisation des suggestions orthographiques basé sur les trigrammes pour l'anglais, l'allemand et l'espagnol : la suggestion correcte apparaît désormais en première position dans environ 80 % des cas, contre environ 62 % sans ce système de hiérarchisation.
  • Des dictionnaires enrichis comprenant plus de 2 000 nouvelles entrées et plus de 600 termes médicaux dans plusieurs langues
  • Les suggestions de saisie automatique s'accompagnent désormais d'une indication au clavier (Tab / →) permettant d'accepter les compléments proposés
  • Plus de 80 nouvelles règles de style anglais portant sur les grossièretés, les propos discriminatoires et le langage inclusif
  • Amélioration de la fiabilité de la relecture par IA grâce à la désactivation de 15 règles problématiques en anglais, en allemand et en espagnol
  • Ajout de ressources linguistiques en grec et en tchèque ; mise à jour du dictionnaire Hunspell tchèque
  • Avertissement relatif à l'assistant de rédaction basé sur l'IA, localisé en danois et en norvégien
  • Correctif de sécurité. Mise à jour de lucene-core pour corriger la vulnérabilité PRISMA-2021-0081

🛠 Améliorations

Noyau WProofreader JS (v3.38.6019)

  • Ajout d'une info-bulle à côté des suggestions de saisie automatique indiquant comment les accepter (Tab / →). Cette info-bulle s'affiche partout où apparaissent des suggestions de saisie automatique.
  • Ajout de la mention « Powered by WProofreader » dans la fenêtre contextuelle de suggestions de l'extension de navigateur, du plugin WordPress et de l'intégration Drupal.
  • Nous avons repensé la bannière promotionnelle du plugin gratuit SCAYT pour CKEditor 4. La bannière est désormais plus petite et moins envahissante, et comporte un lien vers le site web pour plus d'informations.

✨ Assistant de rédaction basé sur l'IA

  • Nous avons localisé la mention relative à l'IA en danois et en norvégien.

📚 Moteur de vérification orthographique

  • Nous avons mis en place un système de hiérarchisation des suggestions de n-grammes basé sur les trigrammes pour l’anglais, l’allemand et l’espagnol. Ce système remplace l’ancienne approche basée sur les bigrammes et améliore la précision des suggestions orthographiques en prenant en compte des séquences de trois mots au lieu de deux. Lorsque plusieurs variantes orthographiques sont tout aussi plausibles — par exemple, « store », « shore » et « stare » —, le modèle utilise le contexte environnant pour classer la suggestion la plus pertinente en tête. Lors des tests de performance en anglais américain, la suggestion correcte arrive désormais en première position dans environ 80 % des cas, contre 71 % avec l'approche précédente. Chaque modèle linguistique nécessite environ 100 Mo de mémoire vive. Actuellement, seules les suggestions issues du moteur orthographique algorithmique principal sont réorganisées par le modèle n-gramme.
  • Des dictionnaires enrichis comprenant plus de 2 000 nouvelles entrées dans plusieurs langues (notamment l'anglais, l'allemand, l'espagnol, l'ukrainien, le danois, le portugais et le finnois). Ces entrées couvrent un large éventail de catégories : abréviations (formes raccourcies), affixes, biologie, affaires, chimie, termes courants, cuisine, variations dialectales, droit, lieux, néologismes, noms propres, religion, sciences, argot, sport et technologie.
  • Les listes de mots ont été affinées en supprimant les entrées dialectales non valides, les mots inexistants générés par des mécanismes de composition et les erreurs de majuscules.
  • Enrichissement de la terminologie médicale en anglais, espagnol et allemand avec plus de 600 nouvelles entrées portant sur les abréviations médicales, les adjectifs, les noms de maladies et les unités de mesure.
  • Optimisation des règles de segmentation grâce à l'ajout de plus de 20 règles concernant les mots courants, les adverbes et les conjonctions, afin d'éviter toute segmentation erronée, tout en supprimant les règles obsolètes ou trop laxistes.
  • Amélioration de la qualité des suggestions grâce à l'exclusion des termes offensants dans certains contextes et à la suppression des noms d'entreprises qui se confondent avec des mots courants de la langue anglaise.

⚙️ Moteur grammatical

  • Mise à jour du moteur de grammaire tiers, LanguageTool, vers la version 2026-02-13, avec des améliorations dans plusieurs langues.
    • Portugais. Mises à jour importantes comprenant de nouvelles règles stylistiques académiques et formelles, une gestion améliorée de l'accord, des contractions, des homonymes et des virgules, des précisions apportées à la désambiguïsation pour les verbes rares et le marquage des catégories grammaticales, ainsi que de nombreuses réductions des faux positifs. Le portugais (Portugal) a bénéficié d'améliorations stylistiques supplémentaires concernant les mots étrangers, l'évitement des gérondifs et les corrections de vocabulaire.
    • Catalan. Nouvelles règles grammaticales, enrichissement significatif du dictionnaire, améliorations apportées à la vérification des cas et affinements des règles précédemment désactivées. Amélioration de règles spécifiques telles que ESCOLTAR_SENTIR et RESPONDRE_A.
    • Espagnol. Amélioration de la précision du tokeniseur de phrases, ajout de contre-modèles pour les règles d'accord, d'accent, de date et de mois, et amélioration de la prise en charge linguistique dans le contexte médical grâce à l'intégration de nouveaux termes médicaux.
    • Français. Améliorations axées sur la maintenance, notamment des corrections visant à préciser les règles, des ajustements de la position des correspondances, des modifications concernant la distinction entre majuscules et minuscules, ainsi que la prévention de la synthèse de mots erronés.
    • Allemand. Améliorations et perfectionnements progressifs des règles.
    • Ukrainien. Mise à jour du dictionnaire, améliorations apportées à la tokenisation et nouvelle règle grammaticale.

💡 Correction automatique

  • Règles de hiérarchisation affinées pour plus de 120 fautes d'orthographe courantes en anglais, allemand, espagnol, ukrainien, français et portugais.
  • Amélioration de la logique de correction grâce à la suppression de plus de 360 entrées de correction automatique erronées pour l'espagnol, en ciblant spécifiquement les suggestions incorrectes et les formes en majuscules qui étaient auparavant déclenchées par erreur.

📝 Style

  • Mise à jour des règles stylistiques pour l'anglais, avec plus de 80 nouvelles règles portant sur les grossièretés, les insultes et les expressions liées à la race, à l'origine ethnique, au genre et au capacitisme.

🤖 Relecture par IA

  • La fiabilité du moteur d'IA a été améliorée grâce à la désactivation de 15 règles problématiques qui provoquaient des boucles logiques, des décalages de modèles et des suggestions de mots inexistants en anglais, en allemand et en espagnol.
  • Correction de bugs qui entraînaient une identification erronée par l'IA de noms propres inconnus ou proposaient des suggestions inadaptées.

🌐 Langues

  • Ajout de nouvelles ressources linguistiques pour le grec, notamment la désactivation des règles grammaticales problématiques relatives aux parenthèses non appariées. Ajout de nouvelles ressources linguistiques pour le tchèque avec priorisation de l'orthographe.
  • Mise à jour du dictionnaire tchèque Hunspell. Source : dictionnaires tchèques sous licence CC0 de Štěpán Škorpil.

Serveur d'applications

  • Mise à jour des bibliothèques tierces :
    • TensorFlow, de la version 2.11 à la version 2.18 (Linux et Windows)
    • rust_swig, de la version 0.4.0 à la version 0.10.0
    • les tokenizers de la version 0.15.1 à la version 0.22.2

🛡 Sécurité

  • Mise à jour de la bibliothèque « lucene-core » vulnérable utilisée par le moteur de grammaire afin de corriger la faille PRISMA-2021-0081.

v6.9.0

La version 6.9.0 de WProofreader Core comprend des dictionnaires orthographiques et de terminologie médicale enrichis, des règles de grammaire et de style affinées dans plusieurs langues, des améliorations apportées à la relecture par IA et à l'assistant de rédaction par IA pour le danois, des mises à jour des libellés de l'interface utilisateur, des correctifs de sécurité et de nouvelles démos de l'éditeur.

Consultez le résumé ci-dessous.

📝 En bref

  • Des dictionnaires orthographiques enrichis, comprenant plus de 2 200 nouveaux mots dans 12 langues, ainsi qu'une terminologie médicale améliorée dans cinq langues.
  • Amélioration de la correction automatique, des guides de style, de la grammaire et de la qualité de la relecture par IA dans plusieurs langues.
  • Ajout de la prise en charge du danois dans l'assistant de rédaction basé sur l'IA et mise à jour des modèles d'IA sous-jacents.
  • Mise à jour des libellés de l'interface utilisateur, de la terminologie et des localisations.
  • Correction d'une faille de sécurité et ajout de nouvelles démos Slate et Draft.js.
  • Correction de problèmes affectant le fonctionnement de la correction automatique, le fractionnement des phrases et l'utilisation de l'assistant de rédaction basé sur l'IA dans Help Scout.

🛠️ Améliorations

Noyau WProofreader JS

  • Version mise à jour v3.37.6005
  • Mise à jour des noms des libellés et de leurs traductions dans le Généralités section « Paramètres » :
    • Guide de style > Style
    • Corriger automatiquement l'orthographe > Correction automatique
    • Suggestions de saisie semi-automatique > Saisie semi-automatique de texte

Orthographe

  • Des dictionnaires enrichis comprenant plus de 2 200 nouveaux mots répartis dans 12 langues, couvrant les abréviations (y compris les formes raccourcies), les affixes, la biologie, le monde des affaires, la chimie, les expressions familières, les termes courants, les mots composés, les variations dialectales, le vocabulaire littéraire et poétique, la gastronomie, la terminologie juridique, la linguistique, la géographie, les mathématiques et la logique, la terminologie militaire, la musique, les néologismes, les noms propres, les sciences, l'argot, la terminologie spécialisée, le sport, la technologie et les anglicismes, y compris des termes issus d'autres langues et des mots archaïques.
  • Terminologie médicale enrichie en anglais, allemand, italien, espagnol et français, à partir de dictionnaires créés par les utilisateurs (plus de 330 entrées au total), couvrant les abréviations médicales, les maladies, les adjectifs médicaux, les unités de mesure, les noms de médicaments et les termes médicaux associés.
  • Mise à jour du dictionnaire norvégien (nb_NO) afin de corriger des problèmes liés aux mots composés se terminant par -dom, -sel et -ion.
  • Ajout de règles de priorisation pour les suggestions orthographiques en danois.
  • Ajout de règles concernant les mots exclus et les mots offensants exclus dans les suggestions orthographiques en polonais.

Correction automatique

  • Amélioration des règles de correction automatique grâce à la suppression des entrées non valides et à la mise en place d'une hiérarchisation des fautes d'orthographe courantes en anglais, allemand, espagnol, ukrainien et danois.

Style

  • Mise à jour des guides de style ukrainiens, avec des ajouts et quelques corrections concernant les formes anti-surzhyk et les anglicismes.
  • Correction d'une description de mot prêtant à confusion dans le guide de style ukrainien contre le « surzhyk ».
  • J'ai supprimé les entrées des guides de style allemands pour lesquelles la forme correspondante et la suggestion constituent toutes deux des variantes valides ou sont utilisées dans des contextes différents.

Grammaire

  • Mise à jour du moteur de grammaire tiers, LanguageTool, vers la version 2026-01-19. Amélioration de la correction en catalan grâce à des dictionnaires enrichis, une meilleure reconnaissance des expressions composées, des suggestions de pronoms affinées et l'activation de la validation des formes verbales.
  • Amélioration des règles de grammaire anglaise grâce à la suppression de certaines règles fixes des listes de règles désactivées.
  • Règles spécifiques améliorées pour l'espagnol, le portugais et le néerlandais, notamment en ce qui concerne la gestion des parenthèses non appariées, l'accord, l'accentuation, la segmentation, les pronoms clitiques, la césure des pronoms sujets, les anti-modèles pour certaines constructions et la majuscule.
  • Modification des règles afin d'éviter les déclenchements en début de phrase causés par des abréviations en italien et en espagnol.

Relecture par IA

  • J'ai désactivé les règles problématiques qui provoquaient des bugs, des suggestions inexistantes, des décalages dans la mise en page et des boucles pour l'anglais, l'allemand et l'espagnol.

✨ Assistant de rédaction basé sur l'IA

  • Ajout de la prise en charge des opérations textuelles en danois, y compris la traduction des noms d'opérations dans l'interface utilisateur. Les opérations textuelles en danois utilisent Claude Haiku 4.5, à l'exception de « Summarize », qui utilise Sonnet 4.

Important

  • Claude Haiku 3.5 a été remplacé par Haiku 4.5 en raison de sa dépréciation. Haiku 3.5 était auparavant le modèle par défaut pour la plupart des opérations sur du texte non anglophone. L'accès public étendu est disponible jusqu'au 19 mars 2026, la fin de vie du modèle étant prévue pour le 19 juin 2026. Pour plus d'informations, consultez la documentation relative au cycle de vie des modèles AWS Bedrock.

Nous vous recommandons de passer à des versions plus récentes de l'application, qui utilisent des invites adaptées aux modèles pris en charge.

Serveur d'applications

  • Mise à jour de la localisation de la liste des langues, ajout des traductions manquantes, uniformisation de la dénomination des langues selon le format « Langue (Pays) » (par exemple, Anglais (Royaume-Uni)), et changement de nom de la fonction « Détection automatique de la langue » en « Détection automatique ».

🛡️ Sécurité

Mise à jour de la bibliothèque ch.qos.logback vulnérable utilisée par le composant de grammaire afin de corriger la faille CVE-2026-1225

Démos

  • Nous avons ajouté quelques nouvelles démos présentant le correcteur orthographique et grammatical WProofreader intégré aux éditeurs Slate et Draft.js

Essayez les démos :

🐞 Corrections de bugs

  • Noyau WProofreader : impossible d'accepter les suggestions de l'assistant de rédaction IA à l'aide du bouton « Remplacer » dans Help Scout
  • Correction automatique de l'orthographe : les mots figurant dans la liste des suggestions exclues s'affichent comme suggestions de correction automatique
  • Noyau de WProofreader : une coupure de phrase incorrecte au niveau de « e.g. » déclenche une règle pour laquelle il manque des accolades

v6.7.1

La version 6.7.1 de WProofreader Core apporte des améliorations majeures au niveau du dictionnaire, de la grammaire, de l'IA et de la sécurité. Consultez le résumé ci-dessous.

📝 En bref

  • Des dictionnaires enrichis comprenant plus de 1 400 nouveaux mots dans 11 langues
  • Couverture renforcée en matière médicale, juridique et relative aux noms propres
  • Amélioration de la prise en charge de l'anglais, de l'ukrainien, du finnois, du danois et de l'allemand
  • Mise à jour de la correction automatique, des guides de style et des règles de relecture par IA
  • Assistant de rédaction basé sur l'IA mis à jour, avec une nouvelle clause de non-responsabilité et une consigne en allemand améliorée
  • Ajout d'une option permettant de désactiver les règles spécifiques à une langue pour les déploiements auto-hébergés
  • Nouvelle démo Syncfusion
  • Correctifs de sécurité pour les bibliothèques vulnérables

🛠️ Améliorations

Orthographe

  • Des dictionnaires enrichis comprenant plus de 1 400 nouveaux mots répartis dans 11 langues, couvrant les abréviations, les affixes, la biologie, le monde des affaires, les termes courants, la terminologie grecque, la linguistique, les mathématiques et la logique, les termes militaires, la politique, les sciences, le sport, la technologie, les anglicismes, les termes latins, l'économie, le vocabulaire littéraire et poétique, ainsi que d'autres terminologies spécialisées.
  • Terminologie médicale enrichie pour l'anglais, l'allemand, l'espagnol et l'italien, à partir des dictionnaires des utilisateurs (79 entrées).
  • Ajout de noms propres courants dans toutes les langues.
  • Amélioration de la prise en charge des dialectes de l'anglais.
  • Ajout de modèles de découpage en anglais pour les mesures, les mots courants, les termes techniques et les préfixes.
  • Suppression des entrées offensantes, erronées ou inexistantes dans plusieurs langues.
  • Ajout de terminologie juridique en anglais.
  • Amélioration du traitement des mots allemands contenant « ss » à la place de « ß ». Les mots tels que « Fussball » sont désormais considérés comme corrects en allemand (Allemagne) (de_DE) et en allemand (Autriche) (de_AT), au même titre que « Fußball ».

Correction automatique

  • Suppression des entrées de correction automatique erronées en anglais et en espagnol.
  • Ajout de paires de priorités pour les fautes d'orthographe courantes en anglais et en ukrainien.

Style

  • Guides de style améliorés pour l'anglais et l'ukrainien.

Grammaire

  • Amélioration de la grammaire anglaise et ukrainienne grâce à la désactivation des règles dialectales et à l'affinement de l'organisation des règles.
  • Mise à jour du moteur de grammaire tiers, LanguageTool, vers la version 2025-11-09. Amélioration de la correction en catalan grâce à un traitement plus précis des verbes et à la mise à jour des règles grammaticales idiomatiques.

Relecture par IA

  • Nous avons désactivé plusieurs règles problématiques pour l'anglais et l'espagnol qui entraînaient des suggestions en double, des suggestions inexistantes et des problèmes de segmentation incorrects.

✨ Assistant de rédaction basé sur l'IA

  • Ajout d'une mention indiquant que l'assistant de rédaction basé sur l'IA peut commettre des erreurs.
  • Mise à jour de l'invite du système allemand afin de supprimer les schémas courants générés par l'IA et de produire un texte au ton plus naturel. Changement de modèle vers Claude Haiku 4.5 pour les opérations suivantes : développement, réécriture, amélioration et relecture.
  • Mise à jour des consignes en néerlandais (abréger, développer, rendre plus formel) afin de préserver le style de l’auteur : passage au modèle Haiku 4.5 et modification du texte des consignes. Mise à jour
  • Suédois : Raccourcir, réécrire, améliorer — passage au modèle Haiku 4.5 ; Développer — passage au modèle Haiku 4.5 et au texte de la consigne. 

Serveur d'applications

  • Mise à jour du processus de gestion des règles pour les déploiements auto-hébergés. Ajout de la prise en charge de la désactivation des règles par langue (auparavant globale) et déplacement de disabled_rules.json dans le répertoire « Resources » avec des noms de fichiers spécifiques à la langue, par exemple en_US_disabled_rules.json.

🛡️ Sécurité

  • Mise à jour des éléments vulnérables nimbus-jose-jwt.jar bibliothèque utilisée par le composant de grammaire pour gérer : CVE-2025-53864 et CVE-2023-52428.

Démos

  • Nous avons ajouté une nouvelle démo présentant l'intégration de WProofreader à l'éditeur Syncfusion. Essayez la démo.

🐞 Corrections de bugs

  • [WP-6692] Assistant de rédaction IA : nom de composant incorrect en portugais
  • [WP-6698] WProofreader core: shifted underlines in <input> elements in WooCommerce
  • [WP-6699] WProofreader core: shifted underlines in <textarea> elements in WooCommerce

v6.4.1

🛠️ Améliorations

🔤 Correction automatique

  • Amélioration du fonctionnement de la correction automatique pour les adresses e-mail. La correction automatique est désormais désactivée lorsqu'un mot fait partie d'une adresse e-mail (par exemple, en tapant brian@... ne sera plus corrigé automatiquement Brian à Brian). Dans d'autres contextes, les suggestions de majuscules restent actives.

v6.4.0

📝 En bref

  • Importante mise à jour des dictionnaires d'anglais, d'allemand et d'espagnol.
  • Nouvelle base de données multilingue comprenant 461 noms propres et 212 abréviations.
  • Des guides de style enrichis, intégrant un langage inclusif (en anglais) et 1 624 nouvelles entrées en ukrainien.
  • Une correction automatique plus précise, grâce à la suppression des combinaisons non valides et à une hiérarchisation plus intelligente des fautes de frappe et des noms.
  • Mises à jour du moteur grammatical pour l'allemand et l'espagnol, avec une meilleure prise en charge de la ponctuation, de la distinction entre majuscules et minuscules et des mots composés.
  • Nouveau moteur de correction automatique basé sur l'IA pour l'anglais, avec des corrections concernant les tirets, la mise au pluriel, les termes médicaux et les expressions temporelles.
  • Amélioration des moteurs d'IA en allemand et en espagnol, avec moins de suggestions étranges ou erronées.

Améliorations

Orthographe

  • Des améliorations notables dans toutes les langues, avec un enrichissement important des dictionnaires d'anglais, d'allemand et d'espagnol.
  • Nouvelle base de données commune de mots pour toutes les langues, comprenant 461 noms propres et 212 abréviations qui seront reconnus comme des cas valides.
  • Amélioration de la prise en compte de la distinction entre majuscules et minuscules dans les suggestions et les exclusions des suggestions, notamment pour les cas dialectaux, les affixes, les termes techniques, les noms communs et propres, les éléments chimiques, les abréviations raccourcies, les abréviations courantes, les noms propres, les termes archaïques, l'argot et les termes techniques.

Correction automatique

  • Suppression des paires de correction automatique non valides dans lesquelles un mot archaïque ou dialectal est considéré comme un mot valide.
  • Ajout de nouvelles paires de priorités pour les fautes d'orthographe dans les noms propres et les fautes de frappe ou d'orthographe courantes.

Style

  • Modèles dialectaux validés et étendus, modèles douteux, barbarismes et expressions vulgaires pour l'anglais, l'allemand, l'ukrainien et le suédois. 
  • Ajout d'entrées dans le guide de style concernant le langage inclusif envers les personnes LGBTQIA+ et en situation de handicap, en anglais.
  • Amélioration significative du guide de style ukrainien (1 624 entrées) concernant les anglicismes, l'antysurzhyk et les grossièretés.

Grammaire

  • Améliorations apportées au moteur de règles grammaticales tiers pour l'allemand et l'espagnol, visant notamment à réduire les suggestions de ponctuation erronées.
  • Amélioration du mécanisme de gestion de la distinction entre majuscules et minuscules et du traitement des mots composés.

Relecture par IA 

  • Sortie d'une nouvelle version d'un moteur de relecture interne basé sur l'IA pour l'anglais, qui corrige les bugs liés aux tirets (en-dash, em-dash et hyphen), aux pluriels, aux termes médicaux, aux phrases coupées, aux temps du passé et du futur postérieurs à 2021, ainsi qu'aux cas de conversion des indications horaires « am/pm » et « AM/PM » en « a.m. » et « p.m. ».
  • Amélioration des moteurs de correction orthographique pour l'allemand et l'espagnol, notamment en ce qui concerne les mots inexistants, les fautes d'orthographe, les erreurs de ponctuation et les suggestions incongrues.