Versionshinweise

Sehen Sie sich die aktuellen Informationen zu den Produktverbesserungen, Fehlerbehebungen und neuen Funktionen an, die mit jeder Version hinzugefügt wurden.

v6.18.1

WProofreader core v6.18.1 improves AI-based proofreading accuracy, adds visible descriptions for AI-based spelling corrections, and makes feature settings reflect actual availability for the selected language and configuration. It also expands dictionaries across multiple languages, including a specialized English veterinary dictionary, adds a German option to require the eszett (ß) instead of ss, and improves handling of hyphenated words, including words that start with a hyphen. This release also adds an “Apply all” button for accepting every suggestion at once, and fixes several security vulnerabilities.

📝 TL;DR

  • Improved AI-based proofreading for Spanish and German.​
  • Feature settings now reflect actual availability for the selected language and configuration.​
  • Spelling issue descriptions now show a specific message for AI-based spelling corrections in English, Spanish and German.​
  • Lowered AI writing assistant minimum text length to 30 characters.
  • Added a German option to require the eszett (ß) instead of ss, and improved handling of hyphenated words, including words that start with a hyphen.​
  • Added a specialized English veterinary dictionary, disabled by default.​
  • Fixed a French bug that incorrectly suggested removing nonbreaking spaces before punctuation.​
  • Added new API commands and server configuration options for administrators, including retrieving user dictionaries and checking supported languages.​
  • Added an “Apply all” button to accept every suggestion at once in Proofread in dialog mode.
  • Expanded dictionaries and medical terminology across multiple languages. ​
  • Updated Netty, MariaDB Java client, logback-classic, and Jackson Databind to fix security vulnerabilities.

🛠 Verbesserungen

WProofreader JS core (v3.46.6137)

  • Improved the feature settings experience. Controls now reflect actual feature availability for the selected language and configuration.
  • Features that are unsupported or disabled on the backend can now appear as unavailable instead of showing as enabled.
  • Added visible spelling suggestion descriptions. Classified AI-based spelling corrections now show a specific message in the UI in English, Spanish and German.
  • Improved issue count accuracy in badge. Corrections disabled through the disabledRules options no longer count as mistakes.
  • Added an “Apply all” button in Proofread in dialog mode that accepts every found suggestion at once, after you expand the dialog window fully.

API and configuration

  • Extended the get_info API with information about feature availability, including autocomplete, autocorrect, and style, allowing integrations to better reflect backend configuration.
  • Added an API getdicts action for retrieving user dictionaries, letting administrators list all dictionaries in an account. Each response returns up to 1,000 dictionaries. If more exist, a warning indicates that the list is truncated.

Localizations

  • Added interface language list localization for Kurdish (Turkey) and Thai.

Anwendungsserver

KI-gestütztes Korrekturlesen

  • Enhanced Spanish AI-based proofreading to have better performance with underscores, unit changes and decimal separators.
  • Improved German AI-based proofreading to provide better performance on texts with parentheses and non-standard quotation marks written as >><< using greater-than and less-than signs.

Grammatik

  • Added support for disabling individual proofreading rules or rule categories on the server side, so, for example, dash rules can be turned off correctly in every instance for cloud users.
  • Improved English grammar processing for capitalization patterns in technical identifiers (such as ID casing) and common word confusion pairs such as sou versus you.
  • Improved the handling of Swedish bil, art, and kol so if they are used at the end of the sentence and a following word is written in lowercase, we would suggest capitalizing that word. For example, Hon körde sin bil. vägen var nästan tom., the suggestion is Vägen.

Rechtschreibung

  • Expanded dictionaries with 840+ new words across English, German, Spanish, Portuguese, Italian, Dutch, French, and Greek, covering abbreviations, technology terms, common words, proper names, and linguistics terms.
  • Enriched cross-language dictionaries with 150+ proper names and abbreviations, covering companies and software applications such as Etsy, Depop, WebText, and USB-C.
  • Enhanced medical terminology for English, German, and Spanish with 120+ new terms, such as trichogram and hyporexia in English, anatómicamente in Spanish, and Implantatprüfung in German.
  • Added an English veterinary dictionary, disabled by default, covering 180+ terms and abbreviations such as GDV, oclacitinib, and Drontal. It covers all available English dialects and administrators can enable it as needed in self-hosted set-up. For cloud users, now it can be provided upon request to [email protected]. It incorporates terms from AGROVOC (FAO) combined with additional entries.
  • Extended measurement-unit abbreviation spelling suggestions, such as 2GB to 2 GB and 3GHz to 3 GHz, to uppercase and mixed-case abbreviations across many Latin-alphabet languages.
  • Added a rule for German (de_DE, de_AT) that lets administrators require the eszett (ß) instead of ss. By default, both forms are accepted; disabling ALLOW_SS_INSTEAD_OF_ESZETT makes ss spellings incorrect and suggests the ß form instead, and AI suggestions follow the same setting.
  • Improved handling of hyphenated words. Words that start with a hyphen, such as -anforderungen, are now recognized as correct when added to a dictionary with a leading hyphen, for most supported languages, except a few that don’t use hyphens this way, such as Arabic, Hebrew, and Japanese.

Stil

  • Enhanced style rule precision in Spanish by adding contextual awareness to foreign-word suggestions. Suggestions for terms like power now exclude medical contexts such as Doppler, based on user feedback.

KI-Schreibassistent

  • Reduced the minimum text length required to use the AI writing assistant from 100 to 30 characters, making AI-powered text actions available for shorter text.

Automatische Vervollständigung

  • Improved autocomplete language handling by using the detected language as a fallback when automatic language detection has insufficient context, such as with very short text.
  • Improved authorization handling so autocomplete and autocorrect respect the languages enabled for a subscription.
  • Updated autocomplete authorization so it’s available only when at least one applicable check type is enabled for the language.
  • Improved autodetect authorization logic, so requests aren’t incorrectly rejected when an applicable check type is available for an authorized language.
  • Continued improving the filtering of autocomplete suggestions that contain sensitive, unexpected, or discriminatory language.

🐞 Fehlerbehebungen

  • Spelling engine (French): Suggestions incorrectly recommended removing the narrow nonbreaking space before punctuation, such as question marks and colons
  • Spelling engine: Hyphenated words following a number, such as 5-wöchigen or 16-years-old, were incorrectly flagged as misspelled
  • Spelling engine: Users couldn’t add abbreviations with doubled letters, such as PPP or CCCN, to custom dictionaries

🛡️ Sicherheit

  • Updated Netty to 4.2.17.Final, addressing multiple vulnerabilities in the application server’s networking component, including CVE-2026-75595.
  • Updated the MariaDB Java client from 3.4.1 to 3.4.3, addressing CVE-2026-55856, CVE-2026-55857, and CVE-2026-55858 in the application server’s database connectivity component.
  • Updated logback-classic from 1.5.38 to 1.6.3 to fix a directory traversal vulnerability in the application server’s logging component.
  • Updated Jackson Databind from 2.18.9 to 2.18.10, addressing multiple vulnerabilities in the application server, including unsafe reflection, untrusted deserialization, and uncontrolled resource allocation.
v6.17.1

WProofreader core v6.17.1 fixes an issue where native browser spellcheck didn’t turn back on correctly during startup.

🐞 Fehlerbehebungen

  • WProofreader JS core: When autoStartup was set to false, the restoreNativeSpellCheck option was ignored on initialization, leaving native browser spellcheck disabled. Native browser spellcheck now restores correctly in this configuration. Review configuration options Weitere Informationen finden Sie hier.

v6.17.0

WProofreader Core v6.17.0 führt die deutsche KI-basierte Korrektur-Engine v3.1 mit verbesserten Grammatik- und Zeichensetzungskorrekturen ein, erweitert die Beschreibungen und Kategorien der KI-Korrekturen auf Deutsch und Spanisch, ergänzt die Wörterbücher um mehr als 970 neue Wörter, aktualisiert die algorithmische Grammatik-Engine mit Verfeinerungen für Portugiesisch und Italienisch, verbessert die Eingabeaufforderungen des KI-Schreibassistenten und behebt mehrere Sicherheitslücken.

📝 Kurzfassung

  • Veröffentlichung der deutschen KI-basierten Korrekturlesungs-Engine (v3.1) mit verbesserten Korrekturen
  • Erweiterung der KI-gestützten Korrekturlesung um die Klassifizierung von Fehlern und kuratierte Korrekturbeschreibungen für Deutsch und Spanisch
  • Erweiterte Wörterbücher mit über 970 neuen Wörtern in fünf Sprachen sowie 170 gemeinsamen Eigennamen und Abkürzungen
  • Erweiterte medizinische Terminologie für Englisch und Spanisch; erweiterte Unterstützung für englische Dialekte
  • Aktualisierte Grammatik-Engine eines Drittanbieters mit Verbesserungen für Portugiesisch und Italienisch
  • Sicherheitsupdates für Micrometer und Netty zur Behebung von Speicherlecks und Problemen bei der Zertifikatsvalidierung

🛠 Verbesserungen

KI-gestütztes Korrekturlesen

  • Die deutsche KI-basierte Korrektur-Engine (v3.1) wurde veröffentlicht. Sie bietet eine verbesserte Genauigkeit bei trennbaren Verben, Modalverben im Präteritum, Passivkonstruktionen, der Substantiv-Verb-Kongruenz sowie bei der Zeichensetzung.
  • Die Klassifizierung der Übereinstimmungen wurde auf Deutsch und Spanisch ausgeweitet, wodurch nun einheitliche Regelkategorien und Beschreibungen für diese Sprachen zur Verfügung stehen. Nutzer erhalten nun einheitliche, klare Erläuterungen zu den vorgeschlagenen Korrekturen auf Deutsch und Spanisch, die der Qualität des englischen Feedbacks entsprechen.
  • Weitere Verbesserungen in verschiedenen Sprachen: Behandlung von Satzzeichen im Englischen, Anführungszeichen und Abstände bei Halbstrichen im Deutschen sowie Ordnungszahlen, Gedankenstriche, Abstände und Doppelpunkte im Spanischen.

Grammatik

  • LanguageTool wurde auf die Version vom 20. August 2026 aktualisiert.
  • Die portugiesische Grammatiklogik wurde mit einer geänderten Regel aktualisiert. Die Regel regelt die korrekte Verwendung von Bindestrichen in Wörtern, die mit Präfixen gebildet werden, gemäß der portugiesischen Rechtschreibvereinbarung. Die Ausnahmeliste wurde erweitert, um den nicht trennbaren Bindestrich und den Bindestrich U+2010 zu erkennen, wodurch verhindert wird, dass gültige Bindestrichformen fälschlicherweise als Fehler markiert werden.
  • Die Logik der italienischen Grammatik wurde mit 6 geänderten Regeln aktualisiert. Es wurden die Artikelregeln für Anglizismen korrigiert, bei denen der Plural dieselbe Schreibweise wie der Singular haben kann, wie z. B. „meeting“ und „standard“, sowie die Regeln für Homophone präzisiert, wie z. B. „hai“ vs. „ai“ und „ha“ vs. „a“.

Rechtschreibung

  • Erweiterte Wörterbücher mit über 970 neuen Wörtern in den Sprachen Englisch, Deutsch, Spanisch, Portugiesisch und Italienisch, die Abkürzungen, Affixe, Anglizismen, Biologie, Wirtschaft, allgemeine Begriffe, Wirtschaftswissenschaften, Lebensmittel, Rechtsbegriffe, Linguistik, Ortsnamen, Maßeinheiten, Medizin, Neologismen, andere Sprachen, Eigennamen, Religion, Naturwissenschaften, Fachterminologie und Technologie abdecken.
  • Erweiterung der gemeinsamen sprachübergreifenden Wörterbücher um 170 Eigennamen und Abkürzungen, wie beispielsweise XOF, OpenOffice, Eurocontrol usw.
  • Erweiterte medizinische und wissenschaftliche Terminologie für Englisch und Spanisch mit 64 neuen Begriffen, darunter Begriffe wie „Bromobenzoate“ und „fCJD“ im Englischen sowie „urotelio“ im Spanischen.
  • Erweiterte Unterstützung für englische Dialekte mit Varianten für medizinische Fachbegriffe, wie beispielsweise „bunaftine“ (amerikanisch) und „bunaphtine“ (britisch).
  • Verbesserte Autokorrektur mit neuen Begriffspaaren für Englisch und Spanisch, die auf häufige Rechtschreibfehler abzielt, wie beispielsweise „multipanares“ → „multiplanares“.

KI-Schreibassistent

  • Verbesserte englische Anweisungen für präzisere dialektale Korrekturen beim Korrekturlesen.
  • Die Eingabeaufforderungen wurden in allen Sprachen aktualisiert, um Emojis bei der Korrektur von Text beizubehalten und sicherzustellen, dass Emoticons und Emoji-Zeichen während des Korrekturlesens unverändert bleiben.

🛡 Sicherheit

  • Micrometer-Update: Micrometer wurde von Version 1.15.12 auf 1.16.7 aktualisiert, um zwei von Snyk gemeldete Sicherheitslücken zu beheben. Das Update behebt einen schwerwiegenden Speicherleck bei der Metrik-Erfassung, der die Stabilität der Registrierungsdatenbank beeinträchtigen könnte. Außerdem wurde die Abhängigkeit zur Prometheus-Integration aus Kompatibilitätsgründen auf Version 1.16.7 aktualisiert.
  • Netty-Update: „netty-handler“ wurde von Version 4.1.136.Final auf Version 4.1.137.Final aktualisiert, um zwei von Snyk gemeldete Sicherheitslücken zu beheben. Die Korrekturen beheben ein Problem mit einer hohen Schweregradstufe aufgrund einer Nichtübereinstimmung der Hostnamen bei der Zertifikatsvalidierung sowie einen kritischen Fehler bei der Ausnahmebehandlung. Dieses Update kommt allen Nutzern zugute, die auf sichere Netzwerkkommunikation angewiesen sind.
  • VAPT: Der Bericht wurde auf Version 6.17.0 aktualisiert.

v6.16.0

WProofreader Core v6.16.0 führt ein neues Lizenzsystem mit Produktlizenzen, Nutzungsbeschränkungen und Versionsbeschränkungen ein, verbessert die Zuverlässigkeit der englischen Grammatikkorrekturen, aktualisiert die Grammatik-Engine eines Drittanbieters, behebt eine Sicherheitslücke mit hohem Schweregrad und erweitert die Rechtschreibwörterbücher um mehr als 1.960 neue Wörter in neun Sprachen.

📝 Kurzfassung

  • Einführung eines neuen Lizenzformats der Version 4 mit Produktberechtigungen, Nutzungsbeschränkungen und Versionsbeschränkungen
  • Kunden mit selbst gehosteten Instanzen müssen ihre Lizenz nach dem Upgrade auf Version 6.16.0 erneut aktivieren (siehe unten stehende grundlegende Änderungen).
  • Eine Sicherheitslücke mit hohem Schweregrad ( CVE-2026-40984) in einer LanguageTool-Abhängigkeit wurde behoben.
  • Das neue wurde hinzugefügt license_status Befehl sowie verbesserte Berichte und Warnmeldungen zum Ablauf von Lizenzen
  • Die Grammatik-Engine eines Drittanbieters (LanguageTool) wurde auf die Version vom 03.08.2026 aktualisiert.
  • Erweiterte Rechtschreibwörterbücher mit über 1.960 neuen Wörtern in neun Sprachen

⚠️ Wichtige Änderung für Kunden mit eigenem Server

  • Kunden mit selbst gehosteten Instanzen müssen ihre Lizenz ab Version 6.16.0 nach jedem WProofreader-Versions-Upgrade erneut aktivieren. Dadurch wird sichergestellt, dass die aktualisierte Version den Versionsbeschränkungen der Lizenz entspricht. Aktivieren Sie Ihre Lizenz unmittelbar nach dem Upgrade erneut, um Dienstunterbrechungen zu vermeiden. Weitere Informationen finden Sie in der Dokumentation zur Lizenzaktivierung unter Linux, Windows oder Docker.

🛠 Verbesserungen

Lizenzierung

  • Es wurde ein neues Lizenzformat der Version 4 eingeführt, das Produktzuteilungen, Nutzungsbeschränkungen und Versionsbeschränkungen unterstützt. Lizenzen legen nun direkt die Produktberechtigungen und die Upgrade-Berechtigung fest.
  • Das neue wurde hinzugefügt license_status API-Befehl zum Abrufen von Lizenzinformationen. Überprüfung Unterlagen zum Lizenzstatus Weitere Informationen finden Sie hier.
  • Verbesserte Anzeige des Lizenzablaufs, um die genaue verbleibende Zeit in Tagen, Stunden, Minuten und Sekunden anzuzeigen. In den Statusmeldungen wird nun der klarere Wortlaut „Die Lizenz läuft ab in“ verwendet.
  • Es wurde eine Warnmeldung zum Ablauf der Lizenz in den letzten 24 Stunden vor Ablauf hinzugefügt, um zusätzlich daran zu erinnern, die Lizenz vor einer Unterbrechung des Dienstes zu verlängern.

Bereitstellung

  • Bei Docker-Containern kam es manchmal vor, dass die Lizenz nach einem Neustart mit einem neuen Lizenz-Ticket und einer leeren „license.xml“-Datei nicht aktiviert wurde. Dies funktioniert nun einwandfrei, auch bei Konfigurationen, bei denen das Lizenzverzeichnis in einem eingebundenen Volume gespeichert ist.

Grammatik

  • Die Grammatik-Engine eines Drittanbieters (LanguageTool) wurde auf die Version vom 03.08.2026 aktualisiert.
  • Verbesserte Regeln zur englischen Grammatik mit klareren Korrekturen und weniger Fehlalarmen:
    • Ein falscher Komma-Vorschlag vor und in Sätzen, in denen die feststehende Redewendung „ab und zu“ vorkommt, wurde behoben.
    • Es wird nun nicht mehr fälschlicherweise als fehlender Infinitiv markiert, da er in Fachtexten als Substantiv fungieren kann.
    • Es wird nun nicht mehr fälschlicherweise „am“ in Sätzen markiert, in denen ein Name oder Titel dazwischen steht, wie beispielsweise: „Ich, John Smith, CMO von XXX, schreibe Ihnen, um zu bestätigen …“
    • Es wurden Empfehlungen hinzugefügt, Interjektionen am Satzanfang großzuschreiben und mit Satzzeichen zu versehen: ahh endlich → Ahh, endlich
    • Es wurden Vorschläge hinzugefügt, wie Sätze zu interpunktieren sind, die mit einem Ausruf beginnen, auf den „that“ folgt: „Wow, das war knapp“ → „Wow, das war knapp“

Rechtschreibung

  • Erweiterte Wörterbücher mit über 1.960 neuen Wörtern in Englisch, Deutsch, Spanisch, Arabisch, Norwegisch, Italienisch, Albanisch, Griechisch und Portugiesisch. Die neuen Wörter decken den Alltagswortschatz sowie wissenschaftliche und fachspezifische Begriffe ab.
  • Die sprachübergreifenden gemeinsamen Wörterbücher wurden um 26 neue Eigennamen und Abkürzungen erweitert, darunter Begriffe aus den Bereichen Software, Recht, Medizin und Technik, wie beispielsweise AgentCore, GPLv2 und eSIM.
  • Erweitertes medizinisches Vokabular für Englisch, Deutsch und Spanisch mit über 820 neuen Begriffen, Abkürzungen und Krankheitsnamen, wie beispielsweise „cryofixation“ (Englisch), „Leukozyten“ (Deutsch) und „sonografía“ (Spanisch).
  • Erweiterte Abdeckung englischer Dialekte um 10 neue Wortpaare, wie beispielsweise „conization “ und „conisation“.
  • Verbesserte Autokorrektur und Rechtschreibvorschläge für Arabisch, Norwegisch, Italienisch, Spanisch, Deutsch und Englisch, die auf häufige Rechtschreibfehler und dialektale Varianten abzielen, wie beispielsweise „trøt“ → „trøtt“ im Norwegischen.

🛡 Sicherheit

  • Aktualisiert micrometer-core vom 1.7.12 bis zum 1.15.12 zur Behebung CVE-2026-40984, eine Denial-of-Service-Sicherheitslücke mit hohem Schweregrad, die LanguageTool-Abhängigkeiten betrifft, die im Lieferumfang von WProofreader enthalten sind.
  • Außerdem umgestellt auf micrometer-registry-prometheus-simpleclient um die Kompatibilität mit der bestehenden Prometheus-Integration zu gewährleisten.

v6.15.0

WProofreader Core v6.15.0 erweitert die Rechtschreibprüfung um die Unterstützung für Thailändisch und führt die applyAllSuggestions Verfahren, mit dem alle vorgeschlagenen Korrekturen in einem einzigen Aufruf angewendet werden können, und verbessert die Beschreibungen der Korrekturvorschläge in der Grammatik- und der KI-basierten Korrekturlesungs-Engine. Diese Version erweitert außerdem die Wörterbücher um mehr als 1.200 neue Wörter und Begriffe in neun Sprachen, aktualisiert die deutsche Rechtschreibung und enthält Verbesserungen beim Docker-Build sowie Behebungen für mehrere Sicherheitslücken.

📝 Kurzfassung

  • Es wurde eine Unterstützung für die Rechtschreibprüfung für Thailändisch hinzugefügt.
  • Einführung des applyAllSuggestions Methode, um alle vorgeschlagenen Korrekturen in einem Dokument mit einem einzigen Aufruf anzuwenden.
  • Verbesserte Klassifizierung von Vorschlägen in den Grammatik- und KI-Korrekturmodulen, einschließlich einer neuen Erkennung von Stilfehlern.
  • Erweiterte Wörterbücher mit über 1.200 neuen Wörtern und Begriffen in neun Sprachen.
  • Vorschläge für fehlende Punkte sind nun standardmäßig in Überschriften und Listenelementen deaktiviert.
  • Verbesserte Kompatibilität beim Erstellen von Docker-Images zwischen Kaniko, Buildah und dem klassischen Docker-Builder.
  • Sicherheitskorrekturen. Die Bibliotheken „Rangy“, „jackson-databind“ und „ch.qos.logback“ wurden aktualisiert, um folgende Schwachstelle zu beheben CVE-2023-26102, CVE-2026-54515, CVE-2026-9828und CVE-2026-10532.

WProofreader JS-Kern (v3.44.6097)

  • Ein neues wurde hinzugefügt applyAllSuggestions Befehl, der alle vorgeschlagenen Korrekturen auf einmal übernimmt, anstatt sie einzeln anzuwenden. Er steht Entwicklern ab sofort zur Verfügung, um ihn in ihre Konfiguration zu integrieren; eine gebrauchsfertige Schaltfläche in der Benutzeroberfläche wird in einer zukünftigen Version folgen.
  • Erinnerungen an versäumte Perioden werden standardmäßig nicht mehr in Überschriften und Listenelementen angezeigt, wodurch die Anzahl der Vorschläge reduziert wird, die in diesen Kontexten nicht zutreffen. Überprüfen disabledRulesPerEnvironment in der Konfigurationsdokumentation Weitere Informationen finden Sie hier.
  • Die Erkennung deutscher Abkürzungen mit Leerzeichen und Großbuchstaben (wie z. B.) wurde verbessert, sodass sie nun keine falschen Großschreibungsvorschläge mehr auslösen.
  • Verbesserte Handhabung der Option „Domainnamen ignorieren“. Domainnamen werden nun durchgängig übersprungen, auch in Fällen, in denen sie zuvor noch als Rechtschreibfehler markiert wurden. Weitere Informationen finden Sie in der Dokumentation zu den Optionen zum Ignorieren von Rechtschreibfehlern.

Anwendungsserver

  • Veraltete Meldungen zur Hardware-Validierung wurden aus den Protokollen des Anwendungsservers entfernt. Die Hardware wird bereits seit einiger Zeit nicht mehr für die Lizenzvalidierung verwendet, doch die entsprechenden Meldungen waren weiterhin vorhanden und konnten bei der Fehlerbehebung zu Verwirrung führen.

Bereitstellung

  • Verbesserte Zuverlässigkeit beim Erstellen von Docker-Images mit Kaniko, Buildah und dem klassischen Docker-Builder, einschließlich Konfigurationen, bei denen Werte mit --build-arg. Build-Argumente werden nun ordnungsgemäß in jede Phase eines mehrstufigen Builds übernommen, wodurch Fälle behoben wurden, in denen sie in späteren Phasen nicht mehr sichtbar waren.

KI-gestütztes Korrekturlesen

  • Vorschläge der KI-Korrektur-Engine zum Einsatz von Bindestrichen lassen sich nun leichter erkennen und deaktivieren. Dies ist besonders nützlich, wenn Ihr Stilleitfaden die Verwendung von Bindestrichen einschränkt oder verbietet. Weitere Informationen zu den Regeln finden Sie in den Erläuterungen zu den Kategorien und Regeln der KI-Korrektur für Englisch.
  • Neben Rechtschreibung und Grammatik können die Korrekturvorschläge der KI nun auch als stilistische Probleme klassifiziert werden, sodass sie präziser gekennzeichnet werden. Sehen Sie sich die Stilkategorien und Regeln der englischen KI-Korrektur an.
  • Es wurden sorgfältig ausgewählte Erläuterungen zu den Korrekturvorschlägen der KI-gestützten Korrekturlesung für englische Texte hinzugefügt. Unser Sprachteam hat diese Erläuterungen erstellt, damit leichter nachvollziehbar ist, warum ein bestimmter Vorschlag gemacht wurde.

Grammatik

  • Vorschläge der externen Grammatik-Engine werden nun korrekt als Grammatik-, Rechtschreib- oder Stilprobleme gekennzeichnet, sodass sie entsprechend hervorgehoben werden. Zuvor wurde alles aus dieser Engine als Grammatikproblem angezeigt, auch wenn dies nicht der Fall war.
  • LanguageTool wurde auf die Version vom 14.07.2026 aktualisiert.
  • Verbesserte Erkennung deutscher Wörter, die sowohl als Verb als auch als Adjektiv fungieren können, wie beispielsweise „strukturierte“. Bisher wurden einige dieser Wörter ausschließlich als Verb erkannt, was dazu führen konnte, dass die Komma-Regel die Satzstruktur falsch interpretierte und fälschlicherweise vorschlug, ein korrektes Komma zu entfernen.
  • Die Einheitlichkeit der Regelnamen wurde verbessert, sodass das Aktivieren oder Deaktivieren einer bestimmten Grammatikregel nun immer auf die gleiche Weise erfolgt, unabhängig davon, welche Prüf-Engine dafür zuständig ist.

Rechtschreibung

  • Niederländisch erkennt nun Wörter mit Apostrophen, wie beispielsweise „’s-Hertogenbosch“, als korrekt geschrieben an.
  • Verbesserte Rechtschreibvorschläge für deutsche Abkürzungen, bei denen zwischen den beiden Teilen ein Leerzeichen stehen muss, z. B. die Korrektur von „z.B.“ zu „z. B.“
  • Es wurden über 640 neue Wörter und Begriffe in den Sprachen Englisch, Deutsch, Spanisch, Ukrainisch, Bulgarisch, Niederländisch, Thailändisch, Griechisch und Portugiesisch hinzugefügt. Diese umfassen sowohl den Alltagswortschatz als auch Fachgebiete wie Wissenschaft, Wirtschaft und Technik.
  • Das sprachübergreifende gemeinsame Wörterbuch wurde um mehr als 30 neue Eigennamen und Abkürzungen erweitert, darunter Firmen, Produkte und Organisationen wie beispielsweise Canon, Ltd. und Rakuten. Zudem wurde es als zusätzliches Wörterbuch für die griechische Rechtschreibprüfung hinzugefügt.
  • Es wurden 550 neue medizinische Begriffe für Englisch, Deutsch und Spanisch hinzugefügt, darunter Abkürzungen und Bezeichnungen für medizinische Verfahren wie beispielsweise „Hepatoskopie“, „Unkovertebralgelenke“ und „USG“.
  • Erweiterte Unterstützung für englische Dialekte mit 17 neuen Dialektpaaren, wie beispielsweise „hematoporphyrin“ (amerikanisch) und „haematoporphyrin“ (britisch).
  • Über 40 verbesserte Rechtschreib- und Autokorrekturvorschläge für Englisch, Spanisch, Ukrainisch, Bulgarisch, Katalanisch sowie für das sprachübergreifende Wörterbuch. Dabei werden häufige Rechtschreibfehler, Eigennamen und Abkürzungen berücksichtigt, wie beispielsweise „llm“ → „LLM“.

Automatische Vervollständigung

  • Die Autovervollständigung unterbindet nun jegliche Vorschläge, wenn der eingegebene Text Wörter enthält, die als besonders vulgäre Schimpfwörter angesehen werden können.

Sprachen

  • Es wurde eine Rechtschreibkorrektur für die thailändische Sprache implementiert.

🛡 Sicherheit

  • Rangy-Bibliothek: Wir haben den Upstream-Patch für CVE-2023-26102 in unsere in SCAYT3 verwendete Rangy-Bibliothek (Fork) zurückportiert und damit die Sicherheitslücke geschlossen, wobei die Kompatibilität mit unserem Fork gewährleistet blieb.
  • jackson-databind: Wir haben jackson-databind auf Version 2.18.9 aktualisiert, um die Sicherheitslücke CVE-2026-54515 zu beheben. Dies betrifft Komponenten, die direkt oder transitiv von jackson-databind abhängig sind.
  • ch.qos.logback: Wir haben ch.qos.logback von Version 1.5.25 auf 1.5.35 aktualisiert, um zwei Deserialisierungsschwachstellen zu beheben ( CVE-2026-9828 und CVE-2026-10532). Dies betrifft Komponenten, die direkt oder transitiv von ch.qos.logback abhängig sind.

🐞 Fehlerbehebungen

  • Rechtschreibprüfung: Bei langgezogenen Wörtern wie „loooooooooooong“ wurden „Keine Vorschläge“ angezeigt.
  • Rechtschreibprüfung: Unverständliche Buchstabenfolgen wie „fjkdkdjshkhfdk“ führten zu Vorschlägen für völlig andere, echte Wörter.

v6.14.0

WProofreader Core v6.14.0 veröffentlicht die KI-basierte Korrektur-Engine v3.1.0 für Spanisch, erweitert die Unterstützung des KI-Schreibassistenten um Griechisch, verbessert die mehrsprachige Wortzählung, erweitert die Wörterbuchabdeckung um über 7.800 neue Wörter, optimiert die Validierung benutzerdefinierter Wörterbücher und die Behandlung von Apostrophen und enthält Sicherheitsupdates für Jackson-Abhängigkeiten.

📝 Kurzfassung

  • Veröffentlichung der KI-basierten Korrektur-Engine v3.1.0 für Spanisch mit verbesserter Korrekturqualität in den Bereichen Grammatik, Wortgebrauch, Verbformen, Präpositionen, Schreibweise von Zahlen und häufige Wortverwechslungen
  • Der KI-Schreibassistent wurde um die Unterstützung für Griechisch erweitert
  • Optimierter spanischer KI-Schreibassistent durch Umstellung von Anthropic-Modellen
  • Erweiterte Wörterbücher mit über 2.700 neuen Wörtern in verschiedenen Sprachen, darunter Abkürzungen, Eigennamen, Fachbegriffe und linguistische Begriffe
  • Verbesserte Wortzählung und -verarbeitung für mehrere Sprachen, darunter Japanisch und Chinesisch
  • Es wurde die Unterstützung für Bindestriche in Wörterbuchnamen hinzugefügt und die Verarbeitung von Apostrophen in benutzerdefinierten und Benutzerwörterbüchern erweitert.
  • LanguageTool auf die Version vom 12.06.2026 aktualisiert
  • Erweiterte Abdeckung des dänischen und neuseeländischen Englisch-Wörterbuchs
  • Sicherheitsupdates. „jackson-core“ und „jackson-databind“ wurden aktualisiert, um die Sicherheitslücken CWE-770 und CVE-2026-54513 zu beheben.

⚠️ Wichtige Änderung

  • Verbesserte Wortzählung für mehrere Sprachen, einschließlich solcher ohne Leerzeichen. Bisher wurden Wörter anhand von Leerzeichen und Satzzeichen identifiziert, was dazu führte, dass ganze Sätze in Sprachen wie Japanisch und Chinesisch als ein einziges Wort gezählt wurden. WProofreader verwendet nun eine ICU-basierte Segmentierung, um Morpheme für diese Sprachen zu zählen, und liefert so genauere Wortzahlen und Sprachstatistiken. Beispielsweise wird „わかんない“ nun als 3 Morpheme (わか / ん / ない) gezählt statt als 1.

🛠 Verbesserungen

WProofreader JS-Kern (v3.43.6079)

  • Es wurde eine griechische Version des Haftungsausschlusses für den KI-Schreibassistenten hinzugefügt.
  • Die Validierung von Wörtern aus dem Benutzer- und benutzerdefinierten Wörterbuch wurde aktualisiert, um alle zulässigen Apostrophzeichen zu unterstützen.

KI-gestütztes Korrekturlesen

  • Die KI-basierte Korrektur-Engine v3.1.0 für Spanisch wurde veröffentlicht. Die Korrekturqualität wurde in folgenden Bereichen verbessert: Konjunktiv, Zeitformen, Reflexivverben, Präpositionen, Übereinstimmung von Adjektiven und Adverbien, Übereinstimmung von Partizipien, Partitivkonstruktionen, Schreibweise von Zahlen sowie häufige Wortverwechslungen, darunter „ser“ und „haber“. Weitere Informationen zu den Verbesserungen bei der Korrektur von spanischen Texten finden Sie in der Dokumentation.
  • Verbesserte KI-basierte Korrekturleistung in allen Sprachen bei Texten mit hoch- und tiefgestellten Zeichen.

Grammatik

  • LanguageTool wurde auf die Version vom 12.06.2026 aktualisiert.

KI-Schreibassistent

Rechtschreibung

  • Erweiterte Wörterbücher mit über 2.700 neuen Wörtern in Englisch, Deutsch, Spanisch, Ukrainisch, Dänisch und Portugiesisch, darunter Abkürzungen, Fachbegriffe aus der Technik, gebräuchliche Wörter, Eigennamen und linguistische Fachbegriffe. 
  • Auch die deutschen Wörterbücher wurden um mehr als 4.600 neue Substantivformen mit einem verbindenden -s sowie um Formen mit Bindestrich, wie z. B. „Fort-“, erweitert . 
  • Erweiterte medizinische Terminologie für Englisch, Deutsch und Spanisch mit 495 neuen Begriffen, darunter medizinische Adjektive, Krankheitsbezeichnungen und Abkürzungen wie beispielsweise Palmitoylcarnitin, Finkelstein-Test und distrófica.
  • Verbesserte Abdeckung der englischen Dialekte durch neue Wortpaare wie „preprosthetic“ vs. „pre-prosthetic“. 
  • Verbesserte deutsche Textverarbeitung durch die Zulassung von vorangestellten Bindestrichen bei gleichzeitiger Einschränkung der Verwendung von Doppelpunkten innerhalb von Wörtern, wie z. B. bei „-konzepte“.
  • Verbesserte Regeln für die Rechtschreibung und die Autokorrekturvorschläge bei häufigen und phonetischen Rechtschreibfehlern im Englischen und Spanischen, wie beispielsweise „Afroasiatic“ → „Afro-Asiatic“.

Benutzerdefinierte Wörterbücher und Benutzerwörterbücher

  • Verbesserte Validierung von Benutzersprachen-Namen. Bei Sprachen-Namen sind nun Bindestriche zulässig, und es werden lateinische ASCII-Buchstaben, Ziffern, Unterstriche und Bindestriche akzeptiert. Die Validierungsregeln und Fehlermeldungen wurden aktualisiert, um ungültige Namen einheitlicher zu behandeln.
  • Benutzerdefinierte Wörterbücher und Benutzerwörterbücher unterstützen nun das Hinzufügen von Wörtern mit verschiedenen Apostroph-Varianten, wie beispielsweise „l’acqua“, „l’acqua“ usw .

Stil

  • Die Filterung von Vorschlägen für die automatische Vervollständigung, die sensible, unerwartete oder diskriminierende Formulierungen enthalten, wurde weiter verbessert.
  • Es wurde Unterstützung für Stilvorschläge und Muster hinzugefügt, die mit einem Leerzeichen beginnen, wie beispielsweise im Deutschen*in → (m/w/d), um ein einheitliches Muster für „Arzt*in → Arzt (m/w/d)“ und „Professor*in → Professor (m/w/d)“ zu schaffen.

Sprachen

🛡 Sicherheit

  • Upgrade von jackson-core: jackson-core wurde auf Version 2.18.7 aktualisiert, um Folgendes zu beheben CWE-770. Geltungsbereich: Komponenten, die (direkt oder transitiv) von jackson-core abhängig sind, sowie die Pakete von langtool/libs.
  • Upgrade von jackson-databind: jackson-databind wurde auf Version 2.18.8 aktualisiert, um die folgende Sicherheitslücke zu beheben CVE-2026-54513zu beheben. Betroffen sind Komponenten, die (direkt oder transitiv) von jackson-databind abhängig sind und im Paket langtool/libs enthalten sind.

🐞 Fehlerbehebungen

  • WProofreader JS-Kern: In der Benutzeroberfläche von WProofreader erscheinen unerwartet schwarze Aufzählungszeichen (WordPress 7.0, Guttenberg-Plugin). Ein Stilkonflikt wurde behoben, der dazu führte, dass in den Komponenten der WProofreader-Benutzeroberfläche die Standard-Aufzählungszeichen angezeigt wurden.

v6.13.1

WProofreader Core v6.13.1 verbessert die Kompatibilität mit Editoren, die in Shadow-DOM-Containern gehostet werden, indem Fehler bei der automatischen Erkennung, Initialisierung und automatischen Suche von Editoren behoben werden. Außerdem wird die Sicherheit des WProofreader-Docker-Images durch die Behebung von Sicherheitslücken in OpenNLP und Netty verbessert und der VAPT-Bericht aktualisiert.

📝 Kurzfassung

  • Verbesserte Kompatibilität mit Editoren, die in Shadow-DOM-Containern gehostet werden, einschließlich automatischer Erkennung, Initialisierung und Laden von Stilen
  • Die automatische Suchfunktion in Shadow-DOM-Umgebungen wurde korrigiert
  • Die OpenNLP- und Netty-Komponenten im WProofreader-Docker-Image wurden aktualisiert, um sieben gemeldete Sicherheitslücken zu beheben.
  • Der VAPT-Bericht wurde auf Version 6.13.1 aktualisiert und die Konformität des Schwachstellenscanners verbessert

🛠 Verbesserungen

WProofreader JS-Kern (v3.42.6067)

  • Verbesserte Shadow-DOM-Unterstützung. Die automatische Erkennung von Editoren und die Initialisierung des Korrekturlesers für bearbeitbare Elemente, die in Shadow-DOM-Containern gehostet werden, wurden korrigiert. WProofreader erkennt nun aktive Editoren korrekt, behält Instanzen bei, wenn Editoren mit der Seite verbunden bleiben, und lädt die erforderlichen UI- und Markup-Stile innerhalb von Shadow-DOM-Umgebungen. 

🛡 Sicherheit

  • Sicherheitskorrekturen für OpenNLP: Es wurde eine gepatchte OpenNLP-Version 1.9.4 mit zurückportierten Korrekturen für CVE-2026-40682, CVE-2026-42027 und CVE-2026-42440 integriert, wodurch die Kompatibilität mit LanguageTool gewahrt bleibt und gleichzeitig gemeldete Sicherheitslücken behoben werden. Geltungsbereich: OpenNLP-Komponenten, die von LanguageTool transitiv verwendet und im WProofreader-Docker-Image enthalten sind. 
  • Netty-Update: Das im Paket enthaltene Netty wurde von 4.1.133.Final auf 4.1.135.Final aktualisiert, umdie Sicherheitslücken „ “ (CVE-2026-44249, CVE-2026-45416, CVE-2026-45674 und CVE-2026-47691) zu beheben. Betroffenheit: Netty-Komponenten, die von LanguageTool transitiv verwendet und im WProofreader-Docker-Image enthalten sind.
  • VAPT: Bericht auf Version 6.13.1 aktualisieren

v6.13.0

WProofreader Core v6.13.0 stellt die Funktionen des KI-Schreibassistenten auf neue Modelle um und stellt die Unterstützung für Google Docs wieder her, verbessert die Qualität der KI-basierten Korrekturlesung und der Autovervollständigung, erweitert die mehrsprachigen Wörterbücher um über 1.400 Wörter, führt Begrenzungen für benutzerdefinierte Wörterbücher und Stilrichtlinien-Sammlungen ein, aktualisiert die ukrainischen und finnischen Wörterbücher und liefert ein Sicherheitsupdate.

📝 Kurzfassung

  • Nach der Einstellung der Anthropic-Claude-Modelle wurden die Modelle des KI-Schreibassistenten für mehrere Sprachen auf Alternativen von Amazon und Google migriert, um die Leistung zu optimieren.
  • Die ukrainischen und finnischen Wörterbücher wurden aktualisiert 
  • Erweiterte Wörterbücher mit über 1.400 neuen Wörtern in Englisch, Deutsch, Spanisch und Portugiesisch, darunter gebräuchliche Wörter, medizinische Fachbegriffe sowie weitere Eigennamen und Abkürzungen
  • Verbesserte Rechtschreibqualität durch bessere Verarbeitung griechischer Wörter mit Großbuchstaben
  • Verbesserte Filterung von Vorschlägen der automatischen Vervollständigung, die sensible oder diskriminierende Formulierungen enthalten
  • Aktualisierte Stilrichtlinien mit neuen Regeln zu spanischen Anglizismen
  • Verbesserte Qualität der KI-Korrekturlesung bei allen unterstützten Modellen und optimierte KI-Korrekturlesung für Spanisch (Version 3.0) für zuverlässigere Korrekturen.
  • Die Kompatibilität des KI-Schreibassistenten mit Google Docs wurde wiederhergestellt
  • Sicherheitsupdate. OpenTelemetry wurde aktualisiert, um die Sicherheitslücke CVE-2026-45292 zu beheben.

🛠 Verbesserungen

WProofreader JS-Kern (v3.42.6057)

  • Verbesserte Kompatibilität mit Google Docs. Es wurden Probleme behoben, die dazu führten, dass der KI-Schreibassistent in Google Docs nicht ordnungsgemäß funktionierte.

Korrekturlesen durch KI

  • Verbesserte Qualität der KI-Korrekturlesung in den Sprachen Englisch, Deutsch und Spanisch hinsichtlich der Behandlung von Zeichensetzung und Leerzeichen, einschließlich Dezimalkommas, Halbgeviertstrichen und der Zeichensetzung um korrigierten Text herum.
  • Die Korrekturgenauigkeit für Spanisch wurde verbessert, indem redundante Pronomen, unnötige Satzzeichen, Gradzeichen, eckige Klammern und doppelte Vorschläge vermieden wurden.
  • Verbesserte Qualität der Vorschläge im Deutschen durch die Einschränkung des Entfernens von Wörtern am Ende deutscher Sätze.

KI-Schreibassistent

  • Der englische KI-Schreibassistent von Anthropic Claude Haiku 3 wurde nach dessen Auslauf migriert. Weitere Informationen finden Sie in der Dokumentation zu den aktuellen englischen Modellen.
  • Nach der Einstellung von Anthropic Claude Sonnet 4 wurden ausgewählte Arbeitsabläufe der KI-Schreibassistenten für Norwegisch, Italienisch, Spanisch und Dänisch migriert.
  • Die Prompts wurden aktualisiert und der deutsche sowie der ukrainische KI-Schreibassistent von Anthropic Claude Haiku 4.5 migriert, um die Leistung zu steigern.
  • Verbesserte Eingabeaufforderungen für den KI-Schreibassistenten in Niederländisch, Schwedisch, Portugiesisch und Polnisch sorgen für einheitlichere Ergebnisse bei der Überarbeitung, Anpassung des Tons, Kürzung und Erweiterung von Texten.

Rechtschreibung

  • Verbesserte Verarbeitung griechischer Wörter in Großbuchstaben, wie z. B. ΕΙΔΗΣΗ.
  • Erweiterte Wörterbücher mit über 1.000 neuen Wörtern in Englisch, Deutsch, Spanisch und Portugiesisch, die Abkürzungen, Affixe, Biologie, gebräuchliche Wörter, dialektale Varianten, Lebensmittel, Linguistik, Musik, Eigennamen, Slang und Technologie abdecken.
  • Die gemeinsamen sprachübergreifenden Wörterbücher wurden um mehr als 30 Eigennamen und Abkürzungen erweitert, darunter „Googlebot“ und „ISO“.
  • Erweiterte medizinische Fachterminologie in Englisch und Spanisch mit 471 neuen Begriffen aus den Bereichen Medizin, Recht, Abkürzungen und verwandten Wortfeldern.
  • Erweiterte Abdeckung englischer Dialekte durch neue dialektale Wortpaare, wie beispielsweise „radiolabeled “ vs. „radiolabelled“.
  • Verbesserte Vorschlagsregeln für häufige Rechtschreibfehler im Englischen und Spanischen, wie beispielsweise „gritings“ → „greetings“.

Benutzerdefiniertes Wörterbuch

  • Es wurde eine Begrenzung der Anzahl benutzerdefinierter Wörterbücher je nach Abonnementmodell hinzugefügt. Bei selbst gehosteten Instanzen sind bis zu 250 möglich.

Stil

  • Es wurde eine Begrenzung der Anzahl der Style-Guide-Sammlungen je nach Abonnementmodell eingeführt. Bei selbst gehosteten Lösungen sind bis zu 250 zulässig.
  • Der Parameter „collection“ wurde für alle Aktionen mit Stilrichtlinien, die über die API ausgeführt werden, als Pflichtfeld festgelegt.
  • Aktualisierte spanische Stilrichtlinien mit neuen Regeln zu Anglizismen wie „Download“, „Shopping Center“ usw.
  • Es wurde die Möglichkeit hinzugefügt, einen Teil des Musterfelds im Vorschlagsfeld zu verwenden. Beispiel: Lehrer → Lehrer*in

Automatische Vervollständigung

  • Verbesserte Filterung von Vorschlägen für die automatische Vervollständigung, die sensible, unerwartete oder diskriminierende Begriffe enthalten, wie z. B. „Krieg“, „Drogen“ usw.

Sprachen

🛡 Sicherheit

  • OpenTelemetry-Update: OpenTelemetry wurde auf Version 1.62.0 aktualisiert, um folgende Schwachstelle zu beheben CVE-2026-45292zu beheben. Betroffen sind Komponenten, die (direkt oder transitiv) von OpenTelemetry in den Paketen von langtool/libs abhängen.

🐞 Fehlerbehebungen

  • WProofreader JS Core: Der KI-Schreibassistent funktioniert nicht in Google Docs
  • Der KI-Schreibassistent funktioniert nicht mehr für die kostenlose Erweiterung zur automatischen Spracherkennung

v6.11.0

Veröffentlichung von WProofreader Core v6.11.0

WProofreader v6.11.0 vereinfacht die selbst gehostete Bereitstellung, indem es die Anforderungen an den Domainnamen aufhebt, führt neue JS-Kernoptionen für skalierte Layouts und die Steuerung von RTL-Badges ein und ändert das standardmäßige englische Prüfpaket auf ai_lt_hs1 für Cloud-Nutzer erweitert die Wörterbücher um mehr als 9.700 neue Einträge, aktualisiert die Grammatik-Engine mit wesentlichen Verbesserungen für Katalanisch und behebt eine Sicherheitslücke.

Schau dir die Zusammenfassung unten an.

📝 Kurzfassung

  • [Cloud] Die Standardkonfiguration für die Textprüfung im Englischen wurde geändert auf ai_lt_hs1. Kombiniert die KI-Korrektur-Engine mit den algorithmischen Grammatik- und Rechtschreib-Engines für eine höhere Genauigkeit
  • Für die selbst gehostete Installation ist kein Domainname mehr erforderlich – vereinfachte Einrichtung für Docker, Windows und Linux
  • Neue Optionen „enableScale“ und „disableBadgeRTLMirroring“ im WProofreader-JS-Kern
  • Erweiterte Wörterbücher mit über 9.700 neuen Einträgen in Englisch, Deutsch, Spanisch, Ukrainisch und Russisch
  • Erweitertes Deutsch-Wörterbuch mit über 13.550 zusammengesetzten Wortformen für weibliche Substantive mit „Fuge-s“
  • Aktualisierte Grammatik-Engine eines Drittanbieters mit wesentlichen Verbesserungen für Katalanisch sowie Regelverfeinerungen für Deutsch, Spanisch, Portugiesisch, Ukrainisch und Englisch
  • Benutzerdefinierte Wörterbücher akzeptieren nun auch Wörter, die bereits in den Standard-Rechtschreibwörterbüchern enthalten sind.
  • Sicherheitskorrektur. „jackson-core“ wurde aktualisiert, um das Problem GHSA-72hv-8253-57qq zu beheben.

🛠 Verbesserungen

WProofreader JS-Kern (v3.39.6037)

  • Es wurde eine neue Option „enableScale“ eingeführt. Sie aktiviert die Unterstützung für CSS-Skalierungstransformationen, die auf übergeordnete Elemente angewendet werden. Wenn diese Option aktiviert ist, erkennt WProofreader den Skalierungswert des übergeordneten Elements und passt die UI-Elemente entsprechend an, sodass Hervorhebungen und Oberflächenelemente auch bei einer Skalierung des umgebenden Inhalts korrekt ausgerichtet bleiben. Standardmäßig deaktiviert.
  • Es wurde eine neue Option „disableBadgeRTLMirroring“ eingeführt. Diese deaktiviert die automatische Spiegelung der Badge-Position für Sprachen mit Rechts-nach-Links-Schreibrichtung (RTL) wie beispielsweise Arabisch. Bei Aktivierung behält das Badge seine konfigurierte Position bei, anstatt automatisch entsprechend der Textrichtung gespiegelt zu werden. Die Optionen zur manuellen Positionierung des Badges bleiben unverändert. Standardmäßig deaktiviert.

Bereitstellung

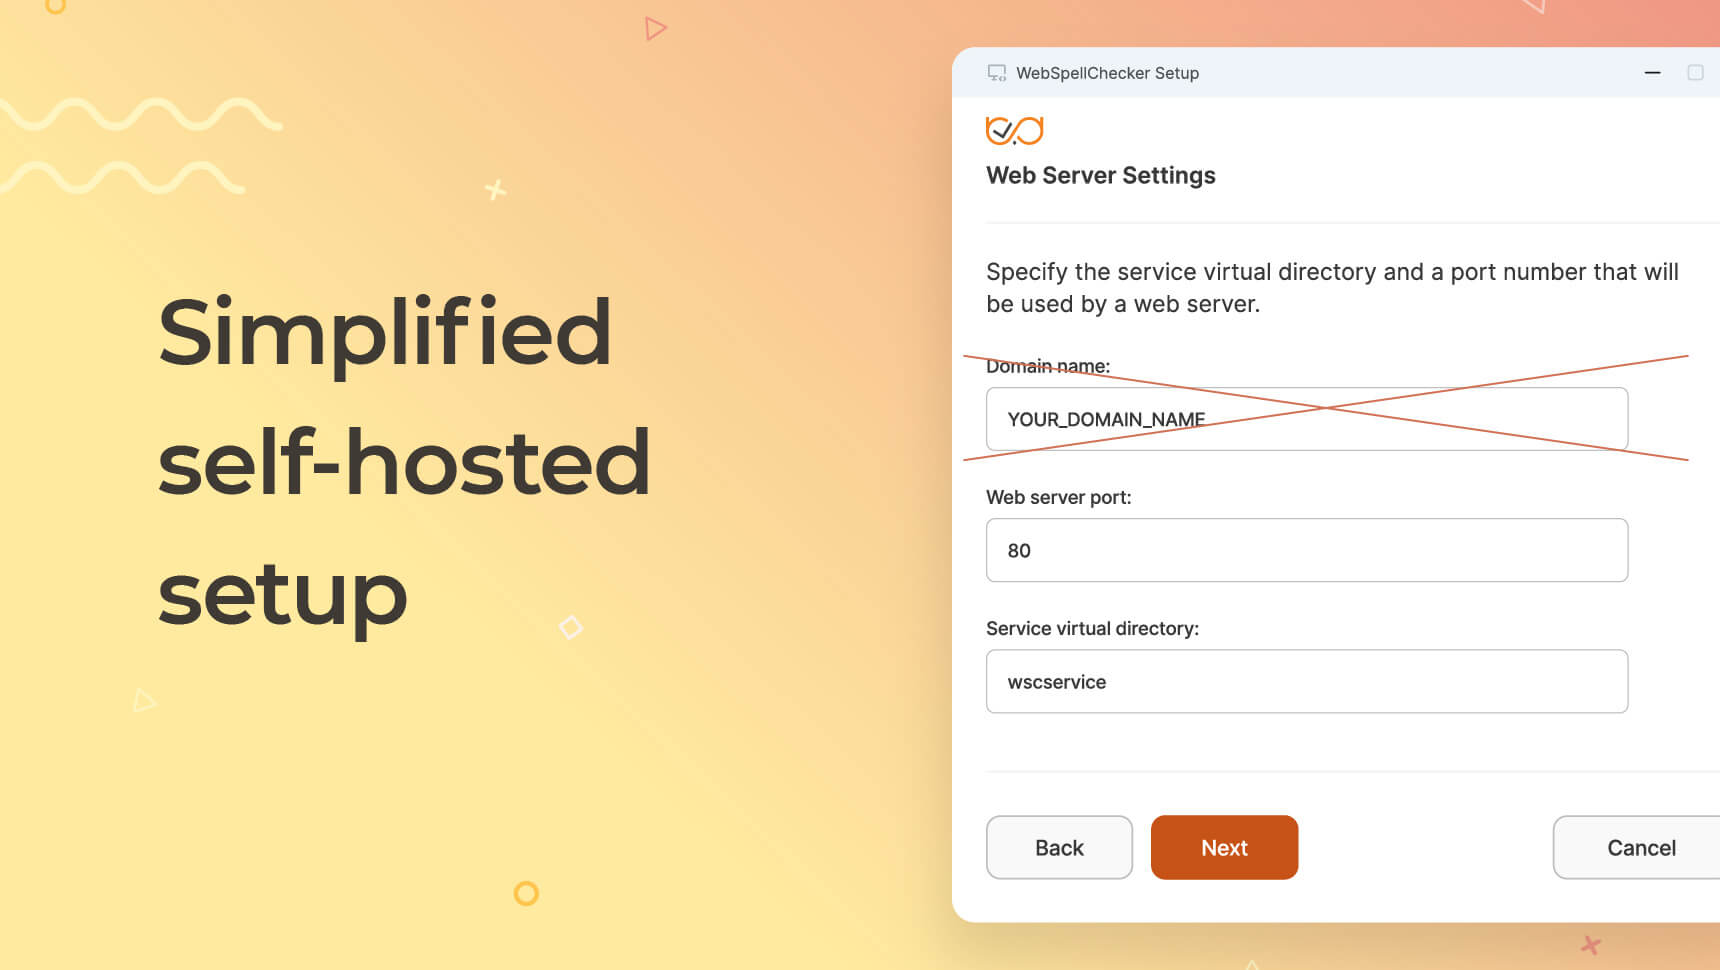
  • Die Anforderung, bei der Installation der selbst gehosteten Version einen Domänennamen anzugeben, wurde entfernt. Dies vereinfacht die Ersteinrichtung in Docker-, Windows- und Linux-Umgebungen:
    • Docker. Das WPR_DOMAIN_NAME Parameter. Es wurde die Unterstützung für die Ausführung des Containers vom Stammverzeichnis aus hinzugefügt (/) über WPR_VIRTUAL_DIR. Erfahren Sie mehr über die Docker-Konfiguration.
    • Helm-Diagramm. Aktualisiert auf Version 1.3.1. Leere Einstellung zulässig virtualDir (/), entfernt WPR_DOMAIN_NAME aus dem extraEnv Beispiel und aktualisiert appVersion zu 6.11.0.0. Erfahren Sie mehr über die Kompasskarte.
    • Installationsprogramme für Windows und Linux. Der Webserver hört nun standardmäßig auf jeder beliebigen Domain, wodurch ein üblicher Einrichtungsschritt entfällt.

Anwendungsserver

  • [Cloud] Die Standardkonfiguration für die Textprüfung für Englisch wurde geändert auf ai_lt_hs1. Diese Konfiguration kombiniert die KI-Korrektur-Engine mit der algorithmischen Grammatik-Engine (LanguageTool) und der algorithmischen Rechtschreib-Engine (Hunspell) mit Rechtschreibvorschlägen für eine höhere Genauigkeit. Bisher war die Standardkonfiguration (ai_lt_hs0) enthielt Hunspell zur Fehlererkennung, jedoch ohne Rechtschreibvorschläge. Bei Bedarf kann das bisherige Verhalten wiederhergestellt werden, indem die checkKit Möglichkeit, ai_lt_hs0.
  • Verbesserte Fehlerprotokollierung. Der Anwendungsserver gibt nun detailliertere Meldungen aus, wenn Hunspell-Wörterbücher nicht geladen werden können, wenn ein KI-Sprachmodell fehlt oder wenn ein N-Gram-Modell nicht gefunden wird. Dies erleichtert die Diagnose von Konfigurationsproblemen während der Bereitstellung.
  • Es wurde die Möglichkeit hinzugefügt, die maximale Sequenzlänge in der Konfiguration des KI-Modells festzulegen.
  • Die Verarbeitung von Dateipfaden auf dem Anwendungsserver wurde verbessert, sodass nun absolute Pfade verwendet werden, anstatt im aktuellen Arbeitsverzeichnis zu suchen. Dadurch werden Probleme behoben, die auftreten, wenn der Anwendungsserver unter Linux als systemd-Dienst ausgeführt wird.

Grammatik

  • Die Grammatik-Engine eines Drittanbieters wurde aktualisiert und um Verbesserungen für mehrere Sprachen erweitert.
    • Katalanisch. Umfangreiches Update mit einem neuen System zur Erkennung von Eigennamen, das falsche Rechtschreibfehler bei zuvor im Text vorkommenden Namen reduziert, verbesserten Vorschlägen zum Ersetzen von Verben mit optimierter Behandlung von Pronomen, einem neuen Multitoken-Rechtschreibwörterbuch für bessere Rechtschreibvorschläge bei Mehrwortausdrücken, zusätzlicher Unterstützung für Kausalkonstruktionen (al no + Infinitiv → com que…), einem auf Version 3.3 aktualisierten katalanischen POS-Wörterbuch, erweiterten Rechtschreib- und Mehrwortwörterbüchern, verbesserter Satzsegmentierung mit der Abkürzung „fund“. Abkürzung für Katalanisch und Spanisch sowie verschiedene Verfeinerungen der Regeln zur Begriffsklärung.
    • Deutsch. Die Grammatikregeln für die Konstruktion „nach zu geben“ wurden verbessert und es wurden Regeln für die Verarbeitung der deutschen Zahlenformatierung mit Punkttrennzeichen (z. B. 100.000) hinzugefügt.
    • Spanisch. Es wurde ein Antipattern für „volares“ als Adjektiv hinzugefügt, um falsche Vorschläge im Konjunktiv zu vermeiden.
    • Portugiesisch. Wesentliche Verbesserungen bei der Begriffsklärung, darunter eine bessere Behandlung von „pela/pelas“ als Präpositionen, eine verfeinerte Begriffsklärung zwischen Verben und Substantiven bzw. Adjektiven, eine neue kontextbasierte Kennzeichnung für semantische Kategorien, die Aktivierung der Regel zum redundanten Komma nach einem Gedankenstrich, erweiterte Regeln für leicht zu verwechselnde Wörter, hinzugefügte Antimuster für Verweise auf den Berg K2 und das Samsung Galaxy sowie verschiedene Verfeinerungen der Stilregeln für brasilianisches Portugiesisch.
    • Ukrainisch. Das morphologische Wörterbuch wurde auf Version 6.7.5 aktualisiert, die Verarbeitung von Abkürzungen wurde erweitert (z. B. крим, пом, суч), die Muster für die Worttrennung wurden verbessert, zahlreiche Vorschläge für weiche Ersetzungen wurden hinzugefügt, die Ableitungsregeln wurden erweitert und die Eindeutigkeitsbestimmung für den Vokativ sowie andere grammatikalische Konstrukte wurde verbessert.
    • Englisch. Die Begriffe „misgendered“, „misgender“, „misgenders“ und „misgendering“ wurden in das Rechtschreibwörterbuch aufgenommen und die Behandlung von Präfixen bei den Rechtschreibvorschlägen verbessert.

Rechtschreibung

  • Erweiterte Wörterbücher mit über 9.700 neuen Einträgen in Englisch, Deutsch, Spanisch, Ukrainisch und Russisch, die Abkürzungen, Affixe, Biologie, Chemie, gängige Begriffe, dialektale Varianten, Medizin, Militär, Neologismen, Eigennamen, Technik und vieles mehr abdecken.
  • Das deutsche Wörterbuch wurde um mehr als 13.550 „Fuge-s“-Zusammensetzungen für weibliche Substantive erweitert, die mit einem Bindestrich kombiniert werden (z. B. „Präventions-“).
  • Die gemeinsamen sprachübergreifenden Wörterbücher wurden um 125 neue gebräuchliche Eigennamen und Abkürzungen erweitert.
  • Es wurden neue Ressourcen in russischer Sprache hinzugefügt.
  • Die Wortlisten wurden verfeinert, indem über 500 ungültige oder fehlerhafte Einträge in Englisch, Spanisch und Deutsch entfernt wurden. Dabei wurden nicht existierende Wörter, falsche medizinische Begriffe, ungültige Abkürzungen und großgeschriebene Formen sowie nicht dialektale Einträge aussortiert.
  • Optimierte Worttrennmuster mit 20 neuen Regeln für Englisch und Spanisch, die Reflexivverben, gebräuchliche Wörter, Pronomen und Adverbien abdecken, um eine fehlerhafte Worttrennung zu verhindern. Verbesserte Qualität der Vorschläge durch den Ausschluss anstößiger Begriffe in bestimmten Kontexten und die Entfernung ungültiger Vorschläge über mehrere Kategorien hinweg.
  • Erweiterte medizinische Terminologie für Englisch und Spanisch mit über 255 neuen Einträgen, darunter lateinische Begriffe, medizinische Adjektive, Krankheitsbezeichnungen und Abkürzungen. Verfeinerte medizinische Wortlisten durch das Entfernen von über 230 ungültigen Einträgen, darunter falsche Wörter, Abkürzungsformen und Großschreibungen.
  • Es wurde die Unterstützung für zwei Arten von Apostrophen im Katalanischen (U+2019 und U+0027) hinzugefügt.

Autokorrektur

  • Verfeinerte Priorisierungsregeln für häufige Rechtschreibfehler im Englischen und Spanischen. Verbesserte Priorisierung im gemeinsamen sprachübergreifenden Wörterbuch.
  • Verbesserung der Korrekturlogik durch Entfernen ungültiger Einträge der Autokorrektur für Englisch und Spanisch, die auf falsche Vorschläge abzielten.

Stil

  • Aktualisierte Stilrichtlinien für Englisch mit neuen Vorschriften zu abfälligen Bezeichnungen sowie Beleidigungen aufgrund von Rasse und ethnischer Zugehörigkeit.

Benutzerdefiniertes Wörterbuch

  • Ab Version 6.11.0 können Wörter, die in den Standard-Rechtschreibwörterbüchern enthalten sind, auch zu benutzerdefinierten Wörterbüchern hinzugefügt werden.

🛡 Sicherheit

  • Die anfällige Bibliothek „jackson-core“ (die von der Grammatik-Engine verwendet wird) wurde auf Version 2.18.6 aktualisiert, um das Problem GHSA-72hv-8253-57qq zu beheben (Umgehung der Beschränkung der Zahlenlänge im asynchronen JSON-Parser, was zu einem potenziellen Denial-of-Service-Zustand führen könnte).

🐞 Fehlerbehebungen

  • WProofreader JS-Kern: Hervorgehobene Vorschläge werden verschoben, wenn das Zoom-Plugin im CKEditor verwendet wird
  • WProofreader JS-Kern: Uneinheitliches Verhalten der Tastaturnavigation im Dialogfeld des KI-Schreibassistenten in gemischten Umgebungen mit Links-nach-Rechts- und Rechts-nach-Links-Schreibrichtung
  • Rechtschreibprüfung: Wörter, die mit typografischen Apostrophen geschrieben werden, werden im Katalanischen nicht als korrekt erkannt
  • Rechtschreibmodul: Aufteilungsregeln, die Zahlen enthalten, sind nicht zulässig
  • Anwendungsserver: Die Funktion „Zulässige Regeln“ funktioniert nicht wie erwartet
  • Anwendungsserver: Hunspell bricht ab, wenn das N-Gram-Modell nicht gefunden wird
  • Styleguide: Die wichtigsten Regeln des Styleguides sind nicht lesbar
  • Styleguide: Für Styleguide-Dateien werden relative Pfade verwendet

v6.10.0

WProofreader v6.10.0 bietet eine umfassende Verbesserung der Rangfolge der Rechtschreibvorschläge durch eine auf Trigrammen basierende N-Gram-Priorisierung für Englisch, Deutsch und Spanisch, fügt Tastaturhinweise für die Autovervollständigung hinzu, aktualisiert die Grammatik-Engine, erweitert die Sprachunterstützung um griechische und tschechische Ressourcen und behebt eine Sicherheitslücke.

Schau dir die Zusammenfassung unten an.

📝 Kurzfassung

  • Neue, auf Trigrammen basierende Priorisierung von Rechtschreibvorschlägen für Englisch, Deutsch und Spanisch – der richtige Vorschlag steht nun in ~80 % der Fälle an erster Stelle, gegenüber ~62 % ohne Priorisierung
  • Erweiterte Wörterbücher mit über 2.000 neuen Einträgen und über 600 medizinischen Begriffen in verschiedenen Sprachen
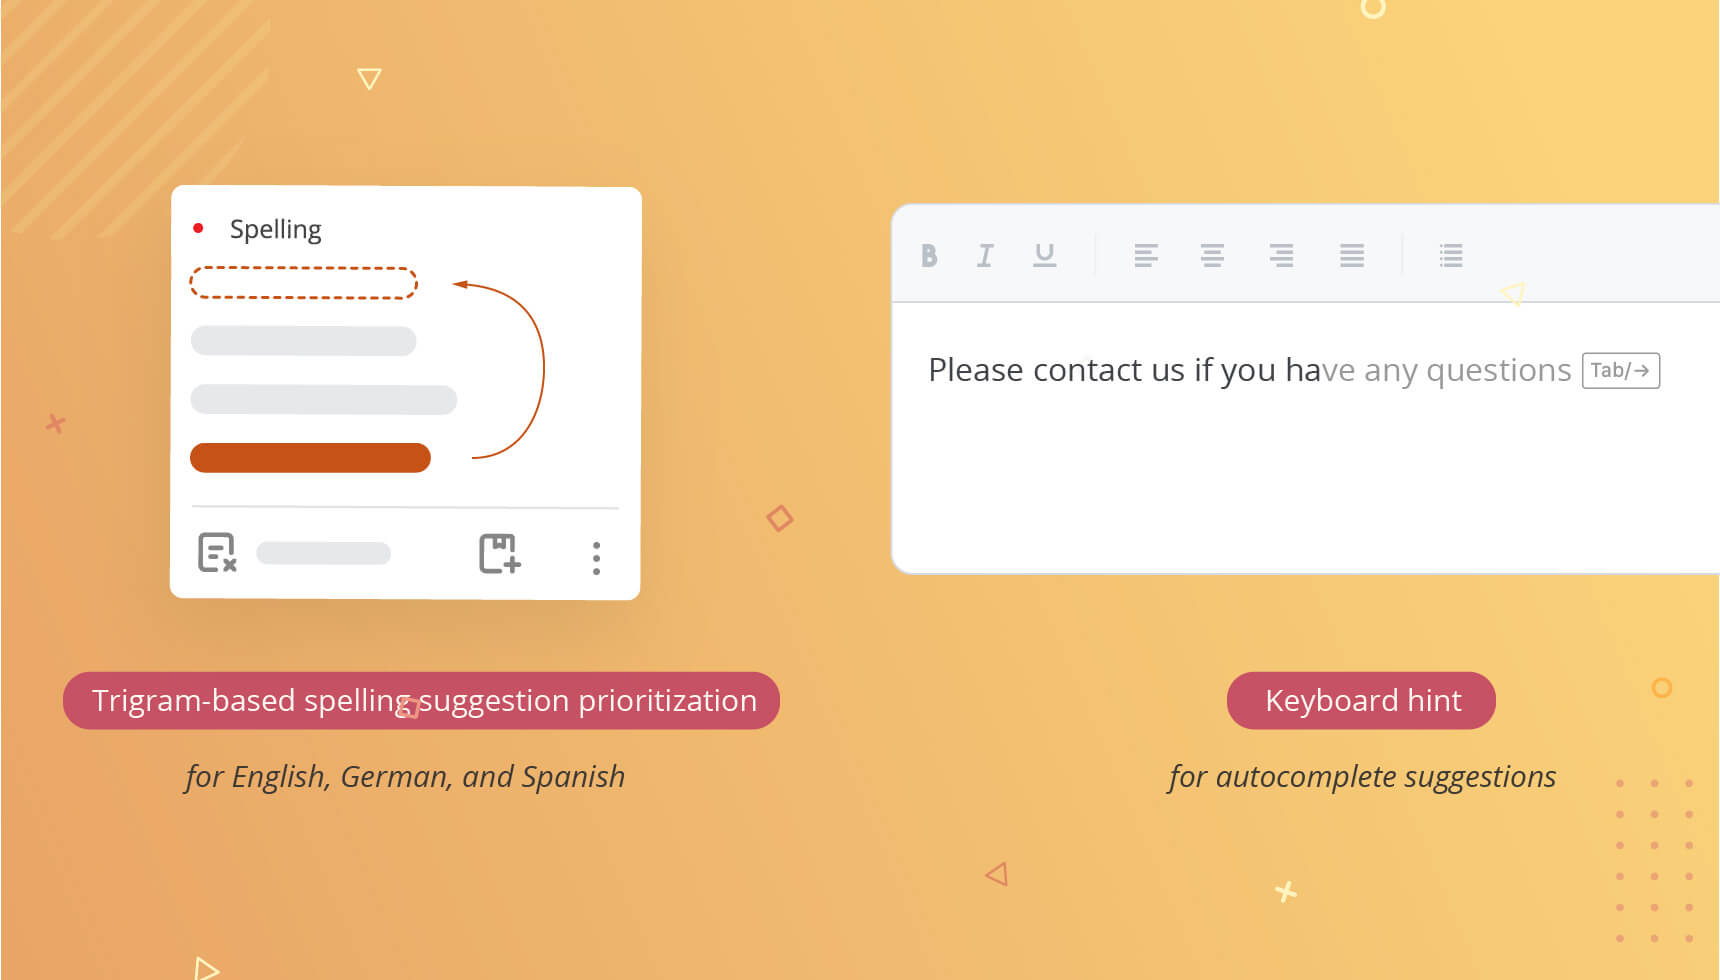
  • Die Vorschläge zur automatischen Vervollständigung zeigen nun einen Tastaturhinweis (Tab / →) zum Übernehmen der Vervollständigungen an.
  • Über 80 neue Regeln für den englischen Schreibstil zu den Themen Schimpfwörter, beleidigende Ausdrücke und inklusive Sprache
  • Verbesserung der Zuverlässigkeit der KI-Korrekturlesung durch Deaktivierung von 15 problematischen Regeln für Englisch, Deutsch und Spanisch
  • Griechische und tschechische Sprachressourcen hinzugefügt; das tschechische Hunspell-Wörterbuch aktualisiert
  • Haftungsausschluss für den KI-Schreibassistenten, lokalisiert für Dänisch und Norwegisch
  • Sicherheitskorrektur. „lucene-core“ wurde aktualisiert, um das Problem PRISMA-2021-0081 zu beheben.

🛠 Verbesserungen

WProofreader JS-Kern (v3.38.6019)

  • Neben den Vorschlägen der Autovervollständigung wurde ein Tastaturhinweis hinzugefügt, der zeigt, wie man diese übernimmt (Tab / →). Der Hinweis wird überall dort angezeigt, wo Vorschläge der Autovervollständigung erscheinen.
  • Im Popup-Fenster mit den Vorschlägen für die Browser-Erweiterung, das WordPress-Plugin und die Drupal-Integration wurde der Hinweis „Powered by WProofreader“ hinzugefügt.
  • Das Werbebanner im kostenlosen SCAYT-Plugin für CKEditor 4 wurde überarbeitet. Das Banner ist nun kleiner und weniger aufdringlich und enthält einen Link zur Website mit weiteren Informationen.

✨ KI-Schreibassistent

  • Der Haftungsausschluss zur KI wurde ins Dänische und Norwegische übersetzt.

📚 Rechtschreibprüfung

  • Es wurde eine auf Trigrammen basierende Priorisierung von N-Gram-Vorschlägen für Englisch, Deutsch und Spanisch eingeführt. Diese ersetzt den bisherigen auf Bigrammen basierenden Ansatz und verbessert die Genauigkeit der Rechtschreibvorschläge, indem statt Zwei-Wort-Sequenzen nun Drei-Wort-Sequenzen berücksichtigt werden. Wenn mehrere Rechtschreibvarianten gleichermaßen plausibel sind – z. B. „store“, „shore“, „stare“ –, nutzt das Modell den umgebenden Kontext, um den relevantesten Vorschlag höher einzustufen. In Benchmark-Tests für amerikanisches Englisch steht der richtige Vorschlag nun in etwa 80 % der Fälle an erster Stelle, verglichen mit 71 % beim bisherigen Ansatz. Jedes Sprachmodell benötigt etwa 100 MB RAM. Derzeit werden nur Vorschläge aus der algorithmischen Haupt-Rechtschreib-Engine durch das N-Gram-Modell neu geordnet.
  • Erweiterte Wörterbücher mit über 2.000 neuen Einträgen in verschiedenen Sprachen (darunter Englisch, Deutsch, Spanisch, Ukrainisch, Dänisch, Portugiesisch und Finnisch). Diese decken ein breites Spektrum an Kategorien ab: Abkürzungen (Kurzformen), Affixe, Biologie, Wirtschaft, Chemie, gängige Begriffe, Kulinarik, dialektale Varianten, Recht, Orte, Neologismen, Eigennamen, Religion, Wissenschaft, Umgangssprache, Sport und Technik.
  • Die Wortlisten wurden bereinigt, indem ungültige dialektale Einträge, nicht existierende Wörter, die durch Wortbildungsmechanismen entstanden sind, sowie falsche Groß- und Kleinschreibung entfernt wurden.
  • Erweiterte medizinische Terminologie in Englisch, Spanisch und Deutsch mit über 600 neuen Einträgen zu medizinischen Abkürzungen, Adjektiven, Krankheitsnamen und Maßeinheiten.
  • Die Trennmuster wurden optimiert, indem über 20 Regeln für gebräuchliche Wörter, Adverbien und Konjunktionen hinzugefügt wurden, um eine falsche Worttrennung zu verhindern, während veraltete oder weniger restriktive Muster entfernt wurden.
  • Die Qualität der Vorschläge wurde verbessert, indem anstößige Begriffe in bestimmten Kontexten ausgeschlossen und Firmennamen entfernt wurden, die sich mit gängigen englischen Wörtern überschneiden.

⚙️ Grammatik-Engine

  • Die Grammatik-Engine des Drittanbieters, LanguageTool, wurde auf die Version 2026-02-13 aktualisiert, die Verbesserungen für mehrere Sprachen enthält.
    • Portugiesisch. Umfangreiche Aktualisierungen, darunter neue akademische und formale Stilregeln, eine verbesserte Behandlung von Konjugation, Kontraktionen, Homonymen und Kommas, Verfeinerungen bei der Begriffsklärung für seltene Verben und der Wortart-Kennzeichnung sowie zahlreiche Reduzierungen von Fehlalarmen. Für Portugiesisch (Portugal) wurden zusätzliche Stilverbesserungen hinsichtlich Fremdwörtern, der Vermeidung von Gerundien und Korrekturen im Wortschatz vorgenommen.
    • Katalanisch. Neue Grammatikregeln, eine umfangreiche Erweiterung des Wörterbuchs, Verbesserungen bei der Kasusprüfung sowie Verfeinerungen an zuvor deaktivierten Regeln. Verbesserte spezifische Regeln wie ESCOLTAR_SENTIR und RESPONDRE_A.
    • Spanisch. Die Genauigkeit des Satz-Tokenizers wurde verbessert, es wurden Antipatterns für Kongruenz-, Akzent-, Datums- und Monatsregeln hinzugefügt und die Sprachunterstützung im medizinischen Kontext durch neue medizinische Fachbegriffe erweitert.
    • Englisch. Wartungsorientierte Verbesserungen, darunter Korrekturen zur Präzisierung der Regeln, Korrekturen der Übereinstimmungspositionen, Anpassungen der Groß-/Kleinschreibung sowie die Vermeidung fehlerhafter Wortsynthese.
    • Deutsch. Schrittweise Verbesserungen und Verfeinerungen der Regeln.
    • Ukrainisch. Wörterbuch-Update, Verbesserungen bei der Tokenisierung und eine neue Grammatikregel.

💡 Autokorrektur

  • Verfeinerte Priorisierungsregeln für über 120 häufige Rechtschreibfehler in Englisch, Deutsch, Spanisch, Ukrainisch, Französisch und Portugiesisch.
  • Verbesserte Korrekturlogik durch das Entfernen von über 360 ungültigen Autokorrektureinträgen für Spanisch, wobei insbesondere falsche Vorschläge und großgeschriebene Formen berücksichtigt wurden, die zuvor versehentlich ausgelöst wurden.

📝 Stil

  • Aktualisierte Stilrichtlinien für die englische Sprache mit über 80 neuen Regeln zu starken Schimpfwörtern, beleidigenden Ausdrücken und Formulierungen in Bezug auf Rasse, ethnische Zugehörigkeit, Geschlecht und Behindertenfeindlichkeit.

🤖 Korrekturlesen mit KI

  • Die Zuverlässigkeit der KI-Engine wurde verbessert, indem 15 problematische Regeln deaktiviert wurden, die Logikschleifen, Musterverschiebungen und Vorschläge für nicht vorhandene Wörter in den Sprachen Englisch, Deutsch und Spanisch verursachten.
  • Es wurden Fehler behoben, bei denen die KI unbekannte Eigennamen fälschlicherweise markierte oder verschobene Vorschläge anbot.

🌐 Sprachen

  • Es wurden neue Sprachressourcen für Griechisch hinzugefügt, wobei problematische Grammatikregeln für nicht gepaarte Klammern deaktiviert wurden. Es wurden neue tschechische Sprachressourcen mit Priorisierung der Rechtschreibung hinzugefügt.
  • Aktualisiertes tschechisches Hunspell-Wörterbuch. Quelle: Tschechische CC0-Wörterbücher von Štěpán Škorpil.

Anwendungsserver

  • Aktualisierte Bibliotheken von Drittanbietern:
    • TensorFlow von 2.11 bis 2.18 (Linux und Windows)
    • rust_swig von 0.4.0 auf 0.10.0
    • Tokenizer von 0.15.1 bis 0.22.2

🛡 Sicherheit

  • Die von der Grammatik-Engine verwendete, anfällige Bibliothek „lucene-core“ wurde aktualisiert, um die Sicherheitslücke PRISMA-2021-0081 zu beheben.

v6.9.0

WProofreader Core 6.9.0 enthält erweiterte Rechtschreibwörterbücher und medizinische Fachbegriffe, verfeinerte Grammatik- und Stilregeln für mehrere Sprachen, Verbesserungen beim KI-Korrekturlesen und beim KI-Schreibassistenten für Dänisch, Aktualisierungen der Benutzeroberflächenbeschriftungen, Sicherheitskorrekturen sowie neue Editor-Demos.

Schau dir die Zusammenfassung unten an.

📝 Kurzfassung

  • Erweiterte Rechtschreibwörterbücher mit über 2.200 neuen Wörtern in 12 Sprachen sowie eine verbesserte medizinische Terminologie in fünf Sprachen.
  • Verbesserte Autokorrektur, Stilrichtlinien, Grammatik und Qualität des KI-Korrekturlesens in mehreren Sprachen.
  • Der KI-Schreibassistent wurde um die Unterstützung für Dänisch erweitert und die zugrunde liegenden KI-Modelle wurden aktualisiert.
  • Aktualisierung der UI-Bezeichnungen, der Sprachbezeichnungen und der Lokalisierungen.
  • Eine Sicherheitslücke wurde behoben und es wurden neue Slate- und Draft.js-Demos hinzugefügt.
  • Es wurden Probleme behoben, die das Verhalten der Autokorrektur, die Satztrennung und die Nutzung des KI-Schreibassistenten in Help Scout betrafen.

🛠️ Verbesserungen

WProofreader JS-Kern

  • Aktualisierte Version v3.37.6005
  • Aktualisierte Bezeichnungen und deren Übersetzungen in der Allgemeines Abschnitt „Einstellungen“:
    • Styleguide > Stil
    • Rechtschreibung automatisch korrigieren > Autokorrektur
    • Vorschläge zur automatischen Vervollständigung > Automatische Textvervollständigung

Rechtschreibung

  • Erweiterte Wörterbücher mit über 2.200 neuen Wörtern in 12 Sprachen, die Abkürzungen (einschließlich Kurzformen), Affixe, Biologie, Wirtschaft, Chemie, Umgangssprache, gebräuchliche Begriffe, zusammengesetzte Wörter, dialektale Varianten, Vokabular aus Belletristik und Lyrik, Lebensmittel, Rechtssprache, Linguistik, Ortsnamen, Mathematik und Logik, Militärterminologie, Musik, Neologismen, Eigennamen, Wissenschaft, Slang, Fachterminologie, Sport, Technologie und Anglizismen, einschließlich Begriffen aus anderen Sprachen und archaischen Wörtern.
  • Erweiterte medizinische Terminologie in Englisch, Deutsch, Italienisch, Spanisch und Französisch auf der Grundlage von Benutzerwörterbüchern (insgesamt über 330 Einträge), die medizinische Abkürzungen, Krankheiten, medizinische Adjektive, Maßeinheiten, Medikamentennamen und verwandte medizinische Begriffe umfasst.
  • Das norwegische Wörterbuch (nb_NO) wurde aktualisiert, um Probleme mit Zusammensetzungen zu beheben, die auf -dom, -sel und -ion enden.
  • Es wurden Priorisierungsregeln für dänische Rechtschreibvorschläge hinzugefügt.
  • Es wurden Regeln für ausgeschlossene Wörter und ausgeschlossene beleidigende Wörter in den polnischen Rechtschreibvorschlägen hinzugefügt.

Autokorrektur

  • Die Regeln für die Autokorrektur wurden verfeinert, indem ungültige Einträge entfernt und häufige Rechtschreibfehler in Englisch, Deutsch, Spanisch, Ukrainisch und Dänisch priorisiert wurden.

Stil

  • Erweiterte ukrainische Stilrichtlinien mit Ergänzungen und einigen Korrekturen hinsichtlich Anti-Surzhyk-Formen und Anglizismen.
  • Eine irreführende Wortbeschreibung im ukrainischen Stilhandbuch gegen „Surzhyk“ wurde korrigiert.
  • Einträge aus deutschen Stilrichtlinien wurden entfernt, bei denen sowohl die Übereinstimmung als auch der Vorschlag gültige Varianten sind oder in unterschiedlichen Kontexten verwendet werden.

Grammatik

  • Die Grammatik-Engine des Drittanbieters, LanguageTool, wurde auf die Version 2026-01-19 aktualisiert. Die Korrektur für Katalanisch wurde durch erweiterte Wörterbücher, eine verbesserte Erkennung von Wortgruppen, verfeinerte Pronomenvorschläge und die Aktivierung der Überprüfung von Verbformen verbessert.
  • Die Regeln der englischen Grammatik wurden verbessert, indem feste Regeln aus den deaktivierten Listen entfernt wurden.
  • Verbesserte sprachspezifische Regeln für Spanisch, Portugiesisch und Niederländisch, einschließlich der Behandlung von nicht gepaarten Klammern, Kongruenz, Akzentuierung, Segmentierung, klitischen Pronomen, Silbentrennung bei Subjektpronomen, Antimuster für bestimmte Konstruktionen und Großschreibung.
  • Die Regeln wurden angepasst, um zu verhindern, dass Abkürzungen im Italienischen und Spanischen Auslöser am Satzanfang verursachen.

Korrekturlesen durch KI

  • Habe problematische Regeln deaktiviert, die zu Fehlern, nicht vorhandenen Vorschlägen, verschobenen Mustern und Schleifen für Englisch, Deutsch und Spanisch führten.

✨ KI-Schreibassistent

  • Es wurde Unterstützung für dänische Textfunktionen hinzugefügt, einschließlich übersetzter Funktionsbezeichnungen in der Benutzeroberfläche. Für dänische Textfunktionen wird Claude Haiku 4.5 verwendet, mit Ausnahme der Funktion „Zusammenfassen“, für die Sonnet 4 zum Einsatz kommt.

Wichtig

  • Claude Haiku 3.5 wurde aufgrund der Auslaufphase durch Haiku 4.5 ersetzt. Haiku 3.5 war zuvor das Standardmodell für die meisten Textverarbeitungsvorgänge in anderen Sprachen als Englisch. Der öffentliche erweiterte Zugriff ist bis zum 19. März 2026 verfügbar, wobei das Ende der Lebensdauer des Modells für den 19. Juni 2026 vorgesehen ist. Weitere Informationen finden Sie in der Dokumentation zum Lebenszyklus von AWS Bedrock-Modellen.

Wir empfehlen, auf neuere Anwendungsversionen zu aktualisieren, deren Eingabeaufforderungen auf die unterstützten Modelle abgestimmt sind.

Anwendungsserver

  • Die Lokalisierung der Sprachenliste wurde aktualisiert, fehlende Übersetzungen wurden hinzugefügt, die Bezeichnungen der Sprachen wurden auf „Sprache (Land)“ (z. B. Englisch (Großbritannien)) vereinheitlicht und die Funktion „Sprache automatisch erkennen“ wurde in „Autodetect“ umbenannt.

🛡️ Sicherheit

Die von der Grammatik-Komponente verwendete, anfällige Bibliothek „ch.qos.logback“ wurde aktualisiert, um die Sicherheitslücke CVE-2026-1225 zu beheben.

Demos

  • Es wurden einige neue Demos hinzugefügt, die die in die Editoren „Slate“ und „Draft.js“ integrierte Rechtschreib- und Grammatikprüfung von WProofreader veranschaulichen. 

Probieren Sie die Demos aus:

🐞 Fehlerbehebungen

  • WProofreader-Kern: Es ist nicht möglich, Vorschläge des KI-Schreibassistenten über die Schaltfläche „Ersetzen“ in Help Scout zu übernehmen
  • Automatische Rechtschreibkorrektur: Wörter aus der Liste der ausgeschlossenen Vorschläge werden als Vorschläge für die automatische Korrektur angezeigt
  • WProofreader-Kern: Eine fehlerhafte Satztrennung bei „z. B.“ löst eine Regel mit fehlenden geschweiften Klammern aus

v6.7.1

WProofreader Core 6.7.1 enthält wichtige Verbesserungen in den Bereichen Wörterbuch, Grammatik, KI und Sicherheit. Lesen Sie dazu die folgende Zusammenfassung.

📝 Kurzfassung

  • Erweiterte Wörterbücher mit über 1.400 neuen Wörtern in 11 Sprachen
  • Erweiterter Versicherungsschutz in den Bereichen Medizin, Recht und Eigennamen
  • Verbesserte Unterstützung für Englisch, Ukrainisch, Finnisch, Dänisch und Deutsch
  • Aktualisierte Autokorrektur, Stilrichtlinien und Regeln für das Korrekturlesen mit KI
  • Aktualisierter KI-Schreibassistent mit einem neuen Haftungsausschluss und einer verbesserten deutschen Eingabeaufforderung
  • Es wurde eine sprachspezifische Regel zum Deaktivieren für selbst gehostete Bereitstellungen hinzugefügt
  • Neue Syncfusion-Demo
  • Sicherheitskorrekturen für anfällige Bibliotheken

🛠️ Verbesserungen

Rechtschreibung

  • Erweiterte Wörterbücher mit über 1.400 neuen Wörtern in 11 Sprachen, die Abkürzungen, Affixe, Biologie, Wirtschaft, gängige Begriffe, griechische Fachbegriffe, Linguistik, Mathematik und Logik, militärische Begriffe, Politik, Wissenschaft, Sport, Technik, Anglizismen, lateinische Begriffe, Wirtschaftswissenschaften, Vokabular aus Belletristik und Lyrik sowie weitere Fachbegriffe abdecken.
  • Erweiterte medizinische Terminologie für Englisch, Deutsch, Spanisch und Italienisch auf der Grundlage von Benutzerwörterbüchern (79 Einträge).
  • Es wurden gemeinsame Eigennamen für alle Sprachen hinzugefügt.
  • Verbesserte Unterstützung für englische Dialekte.
  • Es wurden englische Aufteilungsmuster für Maßeinheiten, gebräuchliche Wörter, Fachbegriffe aus dem Technologiebereich und Vorsilben hinzugefügt.
  • Anstößige, falsche und nicht vorhandene Einträge in verschiedenen Sprachen wurden entfernt.
  • Rechtsbegriffe für Englisch hinzugefügt.
  • Verbesserte Verarbeitung deutscher Wörter, die „ss“ anstelle von „ß“ enthalten. Wörter wie „Fussball“ werden nun in Deutsch (Deutschland) (de_DE) und Deutsch (Österreich) (de_AT) als korrekt behandelt, genau wie „Fußball“.

Autokorrektur

  • Ungültige Autokorrektur-Einträge in Englisch und Spanisch wurden entfernt.
  • Es wurden Priorisierungs-Paare für häufige Rechtschreibfehler im Englischen und Ukrainischen hinzugefügt.

Stil

  • Erweiterte Stilrichtlinien für Englisch und Ukrainisch.

Grammatik

  • Die englische und ukrainische Grammatik wurde verbessert, indem dialektale Regeln deaktiviert und die Organisation der Regeln verfeinert wurden.
  • Die Grammatik-Engine des Drittanbieters, LanguageTool, wurde auf die Version 2025-11-09 aktualisiert. Die Korrekturlesung für Katalanisch wurde durch eine verfeinerte Behandlung von Verben und aktualisierte idiomatische Grammatikregeln verbessert.

Korrekturlesen durch KI

  • Es wurden mehrere problematische Regeln für Englisch und Spanisch deaktiviert, die zu doppelten Vorschlägen, nicht vorhandenen Vorschlägen und falschen Trennungen führten.

✨ KI-Schreibassistent

  • Es wurde ein Haftungsausschluss hinzugefügt, der darauf hinweist, dass der KI-Schreibassistent Fehler machen kann.
  • Die deutsche Systemaufforderung wurde aktualisiert, um häufig vorkommende, von der KI generierte Muster zu entfernen und einen natürlicher klingenden Text zu erzeugen. Das Modell wurde in den Vorgängen „Erweitern“, „Umschreiben“, „Verbessern“ und „Korrekturlesen“ auf „Claude Haiku 4.5“ umgestellt.
  • Die niederländischen Eingabeaufforderungen wurden aktualisiert (gekürzt, erweitert, formeller gestaltet), um den Stil des Autors beizubehalten: Das Modell wurde auf Haiku 4.5 umgestellt und der Text der Eingabeaufforderung angepasst. Aktualisiert
  • Schwedisch: Kürzen, umformulieren, verbessern – Modell auf Haiku 4.5 geändert; Erweitern – Modell auf Haiku 4.5 geändert und Eingabeaufforderung angepasst. 

Anwendungsserver

  • Der Ablauf der Regelverwaltung für selbst gehostete Bereitstellungen wurde aktualisiert. Es wurde die Möglichkeit hinzugefügt, Regeln pro Sprache zu deaktivieren (bisher global), und es wurde disabled_rules.json in das Verzeichnis „Resources“ mit sprachspezifischen Dateinamen, zum Beispiel en_US_disabled_rules.json.

🛡️ Sicherheit

  • Die anfälligen Elemente wurden aktualisiert nimbus-jose-jwt.jar Bibliothek, die von der Grammatikkomponente zur Adressierung verwendet wird: CVE-2025-53864 und CVE-2023-52428.

Demos

  • Es wurde eine neue Demo hinzugefügt, die die Integration von WProofreader in den Syncfusion-Editor veranschaulicht. Probieren Sie die Demo aus.

🐞 Fehlerbehebungen

  • [WP-6692] KI-Schreibassistent: Falscher Komponentenname auf Portugiesisch
  • [WP-6698] WProofreader core: shifted underlines in <input> elements in WooCommerce
  • [WP-6699] WProofreader core: shifted underlines in <textarea> elements in WooCommerce