ملاحظات الإصدار

اطلع على أحدث المعلومات حول تحسينات المنتج، وإصلاحات الأخطاء، والميزات الجديدة التي تُضاف مع كل إصدار.

v6.19.0

WProofreader core v6.19.0 adds Japanese support to the AI writing assistant, improves Dutch spelling suggestions for users with dyslexia, enhances AI-based proofreading accuracy for German and Spanish, patches several security vulnerabilities, and adds the option to raise the rule limit per collection above 2,000 upon request

🛠 التحسينات

الترجمات

  • تمت إضافة ترجمة قائمة لغات الواجهة إلى اللغتين الكردية (تركيا) والتايلاندية.
  • Updated interface language list localization for Valencian.

التدقيق اللغوي باستخدام الذكاء الاصطناعي

  • Added a new German style rule for decapitalizing informal pronoun capitalizations such as Du, Dich, Ihr, and Eure when appropriate.
  • Improved German AI-based proofreading to provide better performance on punctuation in large numbers, subject-verb agreement handling, pronouns in fixed expressions and gender-inclusive suggestions. Also, refined handling of words with nonbreaking hyphens.
  • Enhanced Spanish AI-based proofreading to have better performance on missing question and exclamation marks, run-on sentence detection, and symbol corrections such as +/- → ±.

قواعد اللغة

  • Updated LanguageTool to the October 12, 2026 version. This includes all engine changes since the September 11, 2026 update.

التهجئة

  • Expanded the German dictionary with 850+ new words, covering common vocabulary, specialized fields, business, legal, military and culinary such as eigenkapitalstark, Wendeplatte, Konditoreibetrieb and Gerüstbauarbeiten.
  • Expanded the Portuguese dictionary with 750+ new words covering administrative, common, and proper-name vocabulary such as Maranhão, Catarina, reexaminar and polissonografia.
  • Enhanced German and Spanish medical terminology with 40+ new terms such as Katheterpflege, Kreatininwerte, NTHi.
  • Enriched shared cross-language dictionaries with 60+ new proper-name entries for companies, products, and locations such as Nintendo, Panamera, Rotterdam, and iOS.
  • Improved spelling suggestion prioritization for Dutch with patterns designed to support users with dyslexia, covering cases such as zecht → zegt, leew → leeuw, etc.
  • Improved Dutch spellchecking for hyphenated words, such as compounds with vowel combinations or joining -s-. Correctly written words like these are no longer flagged as errors.
  • Improved suggestions when two words are typed without a space, such as prepositions, conjunctions, or pronouns glued to other words. For example, tojest is now split into the correct words in Polish. This improvement covers 40 languages, including German, Spanish, Portuguese, French, Swedish, Polish, Croatian, Slovenian, Turkish, Welsh, and Irish.
  • Improved suggestions from the third-party grammar engine for Greek. Spelling and style issues are now labeled and highlighted correctly, instead of all appearing as grammar issues.

مساعد الكتابة بالذكاء الاصطناعي

  • Added Japanese support to the AI writing assistant.

Style guide

  • Add a possibility to increase the number of rules per collection to more than 2000 rules upon request. Contact [email protected]

اللغات

🐞 إصلاحات الأخطاء

  • Style guide: Custom rules using a single punctuation character, such as & → und, only matched when spaces were added around the pattern.

🛡️ الأمن

  • Updated dependencies in the AI proofreading engine’s model-serving pipeline to reduce security risk: torch (2.5.1 → 2.9.1), transformers (4.48.1 → 4.57.6), and accelerate (1.3.0 → 1.15.0).
  • Reduced the attack surface of the third-party grammar engine (LanguageTool) by removing 15 unused third-party libraries, including unneeded networking, caching, and cryptography components.
  • Updated Logback, used by the application server, from 1.6.3 to 1.6.5 to fix a known vulnerability: SNYK-JAVA-CHQOSLOGBACK-20824362.
  • Updated Guava, used by the application server, from 33.5.0-jre to 33.7.2-jre to fix a known vulnerability: SNYK-JAVA-COMGOOGLEGUAVA-20825054.
v6.18.1

يعمل الإصدار الأساسي v6.18.1 من WProofreader على تحسين دقة التدقيق اللغوي القائم على الذكاء الاصطناعي، وإضافة أوصاف مرئية لتصحيحات الإملاء التي تتم بواسطة الذكاء الاصطناعي، وجعل إعدادات الميزات تعكس التوافر الفعلي للغة والتكوين المحددين. كما يوسع نطاق القواميس لتشمل لغات متعددة، بما في ذلك قاموس متخصص في الطب البيطري باللغة الإنجليزية، ويضيف خيارًا باللغة الألمانية لفرض استخدام الحرف «إيزت» (ß) بدلاً من «ss»، ويحسن معالجة الكلمات الموصولة بشرطة، بما في ذلك الكلمات التي تبدأ بشرطة. يضيف هذا الإصدار أيضًا زر «تطبيق الكل» لقبول كل الاقتراحات دفعة واحدة، ويصلح العديد من الثغرات الأمنية.

📝 ملخص سريع

  • تحسين عملية التدقيق اللغوي القائمة على الذكاء الاصطناعي للغتين الإسبانية والألمانية.​
  • تعكس إعدادات الميزات الآن التوافر الفعلي للغة والتكوين المحددين.​
  • أصبحت أوصاف مشكلات التهجئة تعرض الآن رسالة محددة تتعلق بالتصحيحات الإملائية التي تعتمد على الذكاء الاصطناعي في اللغات الإنجليزية والإسبانية والألمانية.​
  • تم تخفيض الحد الأدنى لطول النص لمساعد الكتابة الذي يعمل بالذكاء الاصطناعي إلى 30 حرفًا.
  • تمت إضافة خيار باللغة الألمانية لفرض استخدام الحرف «إيزت» (ß) بدلاً من «ss»، كما تم تحسين معالجة الكلمات التي تحتوي على واصلة، بما في ذلك الكلمات التي تبدأ بواصلة.​
  • تمت إضافة قاموس بيطري متخصص باللغة الإنجليزية، وهو معطّل بشكل افتراضي.​
  • تم إصلاح خطأ في النسخة الفرنسية كان يقترح بشكل خاطئ إزالة المسافات غير القابلة للكسر قبل علامات الترقيم.​
  • تمت إضافة أوامر جديدة لواجهة برمجة التطبيقات (API) وخيارات جديدة لتكوين الخادم للمسؤولين، بما في ذلك استرداد قواميس المستخدمين والتحقق من اللغات المدعومة.​
  • تمت إضافة زر«تطبيق الكل»لقبول جميع الاقتراحات دفعة واحدة في ميزة «التدقيق اللغوي» في وضع الحوار.
  • قواميس موسعة ومصطلحات طبية بعدة لغات. ​
  • تم تحديث Netty وماريا دي بي (MariaDB) للعميل جافا وlogback-classic وJackson Databind لإصلاح الثغرات الأمنية.

🛠 التحسينات

نواة WProofreader JS (الإصدار 3.46.6137)

  • تم تحسين تجربة إعدادات الميزات. تعكس عناصر التحكم الآن التوافر الفعلي للميزات بالنسبة للغة والتكوين المحددين.
  • يمكن الآن أن تظهر الميزات غير المدعومة أو المعطلة في الخلفية على أنها غير متاحة، بدلاً من ظهورها على أنها ممكّنة.
  • تمت إضافة أوصاف مرئية لاقتراحات التدقيق الإملائي. أصبحت تصحيحات التدقيق الإملائي المصنفة القائمة على الذكاء الاصطناعي تعرض الآن رسالة محددة في واجهة المستخدم باللغات الإنجليزية والإسبانية والألمانية.
  • تم تحسين دقة حساب عدد المشكلات في الشارة. لم تعد التصحيحات التي تم تعطيلها عبر خيارات disabledRules تُحتسب كأخطاء.
  • تمت إضافة زر«تطبيق الكل»في ميزة «التدقيق اللغوي» في وضع مربع الحوار، والذي يعمل على قبول جميع الاقتراحات التي تم العثور عليها دفعة واحدة، بعد توسيع نافذة مربع الحوار بالكامل.

واجهة برمجة التطبيقات (API) والإعدادات

  • تم تمديد get_info واجهة برمجة التطبيقات (API) التي تحتوي على معلومات حول توفر الميزات، بما في ذلك الإكمال التلقائي والتصحيح التلقائي والأسلوب، مما يتيح للتكاملات أن تعكس بشكل أفضل إعدادات الخلفية.
  • تمت إضافة واجهة برمجة تطبيقات (API) getdicts عملية لاسترداد قواميس المستخدمين، تتيح للمسؤولين عرض قائمة بجميع القواميس الموجودة في الحساب. تعرض كل استجابة ما يصل إلى 1,000 قاموس. وفي حالة وجود عدد أكبر من ذلك، يظهر تحذير يشير إلى أن القائمة قد تم اقتطاعها.

الترجمات

  • تمت إضافة ترجمة قائمة لغات الواجهة إلى اللغتين الكردية (تركيا) والتايلاندية.

خادم التطبيقات

التدقيق اللغوي باستخدام الذكاء الاصطناعي

  • تدقيق لغوي محسّن باللغة الإسبانية يعتمد على الذكاء الاصطناعي لتحقيق أداء أفضل فيما يتعلق بالخطوط السفلية وتغييرات الوحدات وفواصل الأرقام العشرية.
  • Improved German AI-based proofreading to provide better performance on texts with parentheses and non-standard quotation marks written as >><< using greater-than and less-than signs.

قواعد اللغة

  • تمت إضافة دعم لتعطيل قواعد التدقيق اللغوي الفردية أو فئات القواعد من جانب الخادم، بحيث يمكن، على سبيل المثال، تعطيل قواعد استخدام الشرطة بشكل صحيح في كل حالة لمستخدمي الخدمة السحابية.
  • تحسين معالجة قواعد اللغة الإنجليزية فيما يتعلق بأنماط استخدام الأحرف الكبيرة في المعرّفات التقنية (مثل قواعد استخدام الأحرف الكبيرة والصغيرة في المعرّفات ) وأزواج الكلمات التي غالبًا ما يتم الخلط بينها، مثل «sou» و«you».
  • تم تحسين معالجة الكلمات السويدية «bil» و«art» و«kol»، بحيث إذا استُخدمت في نهاية الجملة وتلتها كلمة مكتوبة بحروف صغيرة، فإننا نقترح كتابة تلك الكلمة بحرف كبير. على سبيل المثال، في الجملة «Hon körde sin bil. vägen var nästan tom.»، يكون الاقتراح هو «Vägen».

التهجئة

  • قواميس موسعة تضم أكثر من 840 كلمة جديدة باللغات الإنجليزية والألمانية والإسبانية والبرتغالية والإيطالية والهولندية والفرنسية واليونانية، وتشمل الاختصارات والمصطلحات التقنية والكلمات الشائعة والأسماء الخاصة والمصطلحات اللغوية.
  • قواميس متعددة اللغات مُثريّة تضم أكثر من 150 اسمًا خاصًّا واختصارًا، وتغطي شركات وتطبيقات برمجية مثل Etsy وDepop وWebText وUSB-C.
  • تم تحسين المصطلحات الطبية لللغات الإنجليزية والألمانية والإسبانية بإضافة أكثر من 120 مصطلحًا جديدًا، مثل «trichogram» و«hyporexia» في اللغة الإنجليزية، و«anatómicamente» في اللغة الإسبانية، و«Implantatprüfung» في اللغة الألمانية.
  • تمت إضافة قام بإنشاء قاموس بيطري باللغة الإنجليزية، وهو معطّل افتراضيًا، ويغطي أكثر من 180 مصطلحًا واختصارًا مثل GDV و oclacitinib و Drontal. ويغطي القاموس جميع اللهجات الإنجليزية المتاحة، ويمكن للمسؤولين تفعيله حسب الحاجة في الإعدادات ذاتية الاستضافة. أما بالنسبة لمستخدمي الخدمة السحابية، فيمكن الآن توفيره عند الطلب عبر البريد الإلكتروني [email protected]. ويضم القاموس مصطلحات من AGROVOC (منظمة الأغذية والزراعة) بالإضافة إلى مدخلات إضافية.
  • اقتراحات موسعة لكتابة اختصارات وحدات القياس، مثل تحويل «2GB» إلى «2 GB » و«3GHz» إلى «3 GHz»، لتشمل الاختصارات المكتوبة بأحرف كبيرة أو مزيج من الأحرف الكبيرة والصغيرة في العديد من اللغات التي تستخدم الأبجدية اللاتينية.
  • تمت إضافة قاعدة للغة الألمانية (de_DE، de_AT) تتيح للمسؤولين فرض حرف «إيزيت» (ß) بدلاً من «ss». بشكل افتراضي، يتم قبول كلا النموذجين؛ تعطيل ALLOW_SS_INSTEAD_OF_ESZETT يجعل ss تحتوي على أخطاء إملائية وتشير إلى أن ß استخدم النموذج بدلاً من ذلك، وستتبع اقتراحات الذكاء الاصطناعي نفس الإعداد.
  • تحسين معالجة الكلمات التي تحتوي على واصلة. أصبحت الكلمات التي تبدأ بواصلة، مثل -anforderungen، تُعتبر صحيحة عند إضافتها إلى القاموس مع الواصلة في البداية، وذلك بالنسبة لمعظم اللغات المدعومة، باستثناء عدد قليل منها لا تستخدم الواصلات بهذه الطريقة، مثل العربية والعبرية واليابانية.

الأسلوب

  • تم تحسين دقة قواعد الأسلوب في اللغة الإسبانية من خلال إضافة عنصر «الوعي بالسياق» إلى اقتراحات الكلمات الأجنبية. وبناءً على ملاحظات المستخدمين، أصبحت الاقتراحات الخاصة بمصطلحات مثل «power» تستبعد الآن السياقات الطبية مثل «Doppler».

مساعد الكتابة بالذكاء الاصطناعي

  • تم تخفيض الحد الأدنى لطول النص المطلوب لاستخدام مساعد الكتابة بالذكاء الاصطناعي من 100 إلى 30 حرفًا، مما يتيح استخدام الإجراءات النصية المدعومة بالذكاء الاصطناعي للنصوص الأقصر.

الإكمال التلقائي

  • تم تحسين معالجة اللغة في ميزة الإكمال التلقائي من خلال استخدام اللغة المكتشفة كخيار بديل عندما لا يتوفر سياق كافٍ لعملية الكشف التلقائي عن اللغة، كما هو الحال مع النصوص القصيرة جدًّا.
  • تم تحسين عملية إدارة الصلاحيات بحيث تراعي ميزتا الإكمال التلقائي والتصحيح التلقائي اللغات المُفعَّلة في الاشتراك.
  • تم تحديث ميزة الإكمال التلقائي بحيث لا تتوفر إلا عندما يكون هناك نوع واحد على الأقل من أنواع الفحص القابلة للتطبيق ممكّنًا للغة المعنية.
  • تم تحسين منطق الكشف التلقائي عن التفويض، بحيث لا يتم رفض الطلبات بشكل خاطئ عندما يتوفر نوع فحص مناسب للغة المصرح بها.
  • مواصلة تحسين عملية تصفية اقتراحات الإكمال التلقائي التي تحتوي على لغة حساسة أو غير متوقعة أو تمييزية.

🐞 إصلاحات الأخطاء

  • محرك التدقيق الإملائي (الفرنسية): قدمت الاقتراحات توصيات خاطئة بإزالة المسافة الضيقة غير القابلة للكسر قبل علامات الترقيم، مثل علامات الاستفهام والنقطتين
  • محرك التدقيق الإملائي: تم الإبلاغ بشكل خاطئ عن الكلمات الموصلة بشرطة التي تلي رقمًا، مثل 5-wöchigen أو 16-years-old، على أنها تحتوي على أخطاء إملائية
  • محرك التدقيق الإملائي: لم يكن بإمكان المستخدمين إضافة اختصارات تحتوي على أحرف مكررة، مثل PPP أو CCCN، إلى القواميس المخصصة

🛡️ الأمن

  • تم تحديث Netty إلى الإصدار 4.2.17.Final، لمعالجة ثغرات أمنية متعددة في مكون الشبكات الخاص بخادم التطبيقات، بما في ذلك CVE-2026-75595.
  • تم تحديث عميل MariaDB الخاص بلغة Java من الإصدار 3.4.1 إلى الإصدار 3.4.3، مما أدى إلى معالجة الثغرات الأمنية CVE-2026-55856 وCVE-2026-55857 وCVE-2026-55858 في مكون الاتصال بقاعدة البيانات الخاص بخادم التطبيق.
  • تم تحديث «logback-classic» من الإصدار 1.5.38 إلى الإصدار 1.6.3 لإصلاح ثغرة أمنية تتعلق باجتياز الدلائل في مكون التسجيل الخاص بخادم التطبيقات.
  • تم تحديث مكتبة «Jackson Databind» من الإصدار 2.18.9 إلى الإصدار 2.18.10، لمعالجة ثغرات أمنية متعددة في خادم التطبيقات، بما في ذلك «الانعكاس غير الآمن»، و«إلغاء التسلسل غير الموثوق به»، و«تخصيص الموارد غير الخاضع للرقابة».

v6.17.1

يعمل الإصدار الأساسي v6.17.1 من WProofreader على إصلاح مشكلة عدم إعادة تشغيل أداة التدقيق الإملائي الأصلية للمتصفح بشكل صحيح أثناء بدء التشغيل.

🐞 إصلاحات الأخطاء

  • نواة WProofreader JS: متى autoStartup تم ضبطه على false، الـ restoreNativeSpellCheck تم تجاهل هذا الخيار عند التهيئة، مما أدى إلى تعطيل ميزة التدقيق الإملائي الأصلية للمتصفح. أصبحت ميزة التدقيق الإملائي الأصلية للمتصفح تعمل بشكل صحيح الآن في هذا الإعداد. مراجعة خيارات التهيئة لمزيد من التفاصيل.

v6.17.0

يقدم الإصدار الأساسي v6.17.0 من WProofreader محرك التدقيق اللغوي الألماني القائم على الذكاء الاصطناعي v3.1 مع تحسينات في تصحيحات القواعد النحوية وعلامات الترقيم، ويوسع نطاق أوصاف وفئات تصحيحات التدقيق اللغوي القائمة على الذكاء الاصطناعي لتشمل اللغتين الألمانية والإسبانية، ويضيف أكثر من 970 كلمة جديدة إلى القواميس، ويُحدَّث محرك القواعد النحوية الخوارزمي بتحسينات تتعلق باللغتين البرتغالية والإيطالية، ويُحسِّن تلميحات مساعد الكتابة القائم على الذكاء الاصطناعي، ويعالج العديد من الثغرات الأمنية.

📝 ملخص سريع

  • تم إطلاق محرك التدقيق اللغوي الألماني القائم على الذكاء الاصطناعي (الإصدار 3.1) مع تصحيحات محسّنة
  • Extended categories for AI-based suggestions to German and Spanish
  • قواميس موسعة تضم أكثر من 970 كلمة جديدة في خمس لغات، بالإضافة إلى 170 اسمًا علميًا واختصارًا مشتركًا
  • مصطلحات طبية محسّنة لللغتين الإنجليزية والإسبانية؛ دعم موسّع لللهجات الإنجليزية
  • تم تحديث محرك القواعد النحوية التابع لجهة خارجية مع إدخال تحسينات على اللغتين البرتغالية والإيطالية
  • تحديثات أمنية لبرنامجي Micrometer وNetty لمعالجة تسربات الذاكرة ومشكلات التحقق من صحة الشهادات

🛠 التحسينات

التدقيق اللغوي باستخدام الذكاء الاصطناعي

  • تم إطلاق محرك التدقيق اللغوي الألماني القائم على الذكاء الاصطناعي (الإصدار 3.1) مع دقة محسّنة فيما يتعلق بالأفعال القابلة للفصل، والأفعال الشرطية في صيغة الماضي البسيط، وتراكيب الصيغة المبنية للمجهول، والتوافق بين الاسم والفعل، وتصحيحات علامات الترقيم.
  • Extended categories for AI-based suggestions to German and Spanish, bringing unified rule categories and descriptions to these languages. Users now receive consistent, clear explanations for suggested corrections in German and Spanish, matching the quality of English feedback.
  • تم إجراء تحسينات إضافية دقيقة عبر اللغات المختلفة: معالجة علامات الترقيم في اللغة الإنجليزية، وأنماط علامات الاقتباس والمسافات بين الشرطات القصيرة في اللغة الألمانية، والأرقام الترتيبية والشرطات الطويلة والمسافات وعلامات النقطتين في اللغة الإسبانية.

قواعد اللغة

  • تم تحديث برنامج LanguageTool إلى الإصدار 2026-08-20.
  • تم تحديث منطق قواعد اللغة البرتغالية بإضافة قاعدة معدلة. تتناول هذه القاعدة الاستخدام الصحيح للواصلة في الكلمات المكونة من بادئات وفقًا لاتفاقية قواعد الإملاء البرتغالية. كما تم توسيع قائمة الاستثناءات لتشمل التعرف على الواصلة غير القابلة للكسر والواصلة U+2010، مما يمنع الإبلاغ الخاطئ عن الصيغ الصحيحة التي تحتوي على واصلة.
  • تم تحديث منطق قواعد اللغة الإيطالية بإضافة 6 قواعد معدلة. كما تم تصحيح قواعد استخدام الألفاظ المستمدة من اللغة الإنجليزية التي قد يتشابه فيها صيغة الجمع مع صيغة المفرد في الكتابة، مثل «meeting» و«standard»، بالإضافة إلى توضيح القواعد المتعلقة بالكلمات المتجانسة في النطق، مثل «hai» مقابل «ai»، و«ha» مقابل «a».

التهجئة

  • قواميس موسعة تضم أكثر من 970 كلمة جديدة في اللغات الإنجليزية والألمانية والإسبانية والبرتغالية والإيطالية، وتغطي الاختصارات، واللواحق، والمصطلحات المستمدة من اللغة الإنجليزية، وعلم الأحياء، والأعمال، والمصطلحات الشائعة، والاقتصاد، والأغذية، والمصطلحات القانونية، وعلم اللغة، والمواقع الجغرافية، والوحدات القياسية، والمصطلحات الطبية، والمصطلحات الحديثة، واللغات الأخرى، والأسماء الخاصة، والدين، والعلوم، والمصطلحات المتخصصة، والتكنولوجيا.
  • تم إثراء القواميس المشتركة بين اللغات بإضافة 170 اسمًا خاصًّا واختصارًا، مثل XOF وOpenOffice وEurocontrol، وما إلى ذلك.
  • تم تحسين المصطلحات الطبية والعلمية لللغتين الإنجليزية والإسبانية بإضافة 64 كلمة جديدة، بما في ذلك مصطلحات مثل «bromobenzoates» و«fCJD» باللغة الإنجليزية، و«urotelio» باللغة الإسبانية.
  • تم توسيع نطاق دعم اللهجات الإنجليزية ليشمل الصيغ المختلفة للمصطلحات الطبية، مثل «بونافتين» (الأمريكية) و«بونافتين» (البريطانية).
  • تم تحسين ميزة التصحيح التلقائي بإضافة أزواج جديدة من الكلمات باللغتين الإنجليزية والإسبانية، بهدف تصحيح الأخطاء الإملائية الشائعة، مثل multipanares → multiplanares.

مساعد الكتابة بالذكاء الاصطناعي

  • تحسين التوجيهات باللغة الإنجليزية من أجل تصحيحات لهجية أكثر دقة أثناء مراجعة النصوص.
  • تم تحديث التعليمات في جميع اللغات للحفاظ على الرموز التعبيرية عند إجراء تصحيحات على النص، مما يضمن بقاء الرموز التعبيرية وأحرف الإيموجي دون تغيير أثناء عمليات التدقيق اللغوي.

🛡 الأمن

  • تحديث Micrometer: تم تحديث Micrometer من الإصدار 1.15.12 إلى الإصدار 1.16.7 لمعالجة ثغرتين أمنيتين أبلغت عنهما Snyk. يعمل هذا التحديث على إصلاح تسرب في الذاكرة ذي خطورة عالية في عملية جمع المقاييس، والذي قد يؤثر على استقرار السجل. كما تم تحديث التبعية الخاصة بالتكامل مع Prometheus إلى الإصدار 1.16.7 لضمان التوافق.
  • تحديث Netty: تم تحديث netty-handler من الإصدار 4.1.136.Final إلى الإصدار 4.1.137.Final لمعالجة ثغرتين أمنيتين أبلغت عنهما Snyk. تعالج هذه الإصلاحات مشكلة عدم تطابق اسم المضيف ذات الخطورة العالية في عملية التحقق من صحة الشهادات، بالإضافة إلى عيب خطير في معالجة الاستثناءات. ويستفيد من هذا التحديث جميع المستخدمين الذين يعتمدون على الاتصالات الشبكية الآمنة.
  • VAPT: تم تحديث التقرير إلى الإصدار 6.17.0

v6.16.0

يقدم الإصدار الأساسي v6.16.0 من WProofreader نظام ترخيص جديدًا يتضمن منح المنتجات وحدود الاستخدام وقيود الإصدارات، ويحسن موثوقية تصحيحات قواعد اللغة الإنجليزية، ويُحدّث محرك قواعد اللغة التابع لجهة خارجية، ويعالج ثغرة أمنية شديدة الخطورة، ويوسّع قواميس التدقيق الإملائي بإضافة أكثر من 1,960 كلمة جديدة في تسع لغات.

📝 ملخص سريع

  • تم طرح تنسيق ترخيص جديد من الإصدار 4 يتضمن منح المنتجات، وحدود الاستخدام، وقيود الإصدارات
  • يجب على عملاء الاستضافة الذاتية إعادة تنشيط ترخيصهم بعد الترقية إلى الإصدار v6.16.0 (انظر التغييرات الجذرية أدناه)
  • تم إصلاح ثغرة أمنية شديدة الخطورة، CVE-2026-40984، في إحدى المكتبات التابعة لـ LanguageTool
  • تمت إضافة الجديد license_status الأوامر وتحسين تقارير انتهاء صلاحية التراخيص والتحذيرات المتعلقة بها
  • تم تحديث محرك القواعد النحوية التابع لجهة خارجية (LanguageTool) إلى الإصدار المؤرخ في 3 أغسطس 2026
  • قواميس تهجئة موسعة تضم أكثر من 1,960 كلمة جديدة في تسع لغات

⚠️ تغيير مهم للعملاء الذين يستخدمون خدمة الاستضافة الذاتية

  • يجب على عملاء الاستضافة الذاتية إعادة تنشيط ترخيصهم بعد كل ترقية لإصدار WProofreader، بدءًا من الإصدار v6.16.0. ويهدف ذلك إلى التأكد من أن الإصدار المُرقَّى يتوافق مع قيود الإصدار الواردة في الترخيص. قم بإعادة تنشيط ترخيصك فور الانتهاء من الترقية لتجنب انقطاع الخدمة. راجع وثائق تنشيط الترخيص على أنظمة Linux أو Windows أو Docker لمزيد من المعلومات.

🛠 التحسينات

الترخيص

  • تم طرح تنسيق ترخيص جديد من الإصدار 4 يدعم منح المنتجات، وحدود الاستخدام، وقيود الإصدارات. وتحدد التراخيص الآن بشكل مباشر حقوق استخدام المنتج وأهلية الترقية.
  • تمت إضافة الجديد license_status أمر واجهة برمجة التطبيقات (API) لاسترداد معلومات الترخيص. مراجعة وثائق حالة الترخيص لمزيد من التفاصيل.
  • تم تحسين طريقة عرض تقارير انتهاء صلاحية الترخيص بحيث تُظهر المدة المتبقية بالضبط باليوم والساعة والدقيقة والثانية. وتستخدم رسائل الحالة الآن صيغة أوضح وهي «تنتهي صلاحية الترخيص في ».
  • تمت إضافة تنبيه بانتهاء صلاحية الترخيص خلال الـ 24 ساعة الأخيرة قبل انتهاء الصلاحية، لتوفير تذكير إضافي بتجديد الترخيص قبل انقطاع الخدمة.

النشر

  • كانت حاويات Docker تفشل أحيانًا في تفعيل الترخيص بعد إعادة التشغيل باستخدام تذكرة ترخيص جديدة وملف license.xml فارغ. أصبح هذا الأمر يعمل الآن بشكل صحيح، بما في ذلك في حالات الإعدادات التي تُخزّن دليل الترخيص في وحدة تخزين مُثبَّتة.

قواعد اللغة

  • تم تحديث محرك القواعد النحوية التابع لجهة خارجية (LanguageTool) إلى الإصدار الصادر بتاريخ 3 أغسطس 2026.
  • قواعد نحوية محسّنة للغة الإنجليزية مع تصحيحات أوضح وعدد أقل من الحالات الإيجابية الخاطئة:
    • تم إصلاح اقتراح فاصلة غير صحيح قبل وبعد الجمل التي تستخدم العبارة الثابتة «every now and then»
    • توقفنا عن الإبلاغ الخاطئ عن كلمة «pretrain» على أنها تفتقر إلى صيغة المصدر، نظرًا لأنها يمكن أن تعمل كاسم في النصوص المتخصصة
    • توقف البرنامج عن وضع علامة خطأً على عبارة «am» في الجمل التي يتخللها اسم أو لقب، كما في: «أنا، جون سميث، المدير التنفيذي للتسويق في شركة XXX، أكتب إليكم لتأكيد...»
    • أُضيفت اقتراحات بكتابة الكلمات الاستنادية في بداية الجملة بأحرف كبيرة ووضع علامات الترقيم عليها: ahh finally → Ahh, finally
    • أُضيفت اقتراحات لوضع علامات الترقيم في الجمل التي تبدأ بعبارة تعجب تليها كلمة «that»: «واو، كان ذلك وشيكًا » → «واو، كان ذلك وشيكًا»

التهجئة

  • قواميس موسعة تضم أكثر من 1,960 كلمة جديدة باللغات الإنجليزية والألمانية والإسبانية والعربية والنرويجية والإيطالية والألبانية واليونانية والبرتغالية. وتغطي الكلمات الجديدة المفردات اليومية والعلمية والمتخصصة.
  • تم إثراء القواميس المشتركة متعددة اللغات بإضافة 26 اسمًا علميًا واختصارًا جديدًا، تغطي مصطلحات في مجالات البرمجيات والقانون والطب والتكنولوجيا، مثل AgentCore وGPLv2 وeSIM.
  • مفردات طبية موسعة باللغات الإنجليزية والألمانية والإسبانية، تضم أكثر من 820 مصطلحًا جديدًا واختصارًا واسمًا لأمراض، مثل «cryofixation» (بالإنجليزية)، و«Leukozyten» (بالألمانية)، و«sonografía» (بالإسبانية).
  • تم توسيع نطاق تغطية اللهجات الإنجليزية بإضافة 10 أزواج كلمات جديدة، مثل «conization » و«conisation».
  • تم تحسين ميزة التصحيح التلقائي واقتراحات التهجئة للغات العربية والنرويجية والإيطالية والإسبانية والألمانية والإنجليزية، بحيث تستهدف الأخطاء الإملائية الشائعة والاختلافات اللهجية، مثل trøt → trøtt في اللغة النرويجية.

🛡 الأمن

  • تم التحديث micrometer-core من الإصدار 1.7.12 إلى الإصدار 1.15.12 لإصلاح CVE-2026-40984، ثغرة أمنية عالية الخطورة من نوع «رفض الخدمة» تؤثر على المكونات التابعة لـ LanguageTool المضمنة في WProofreader.
  • كما تم التبديل إلى micrometer-registry-prometheus-simpleclient للحفاظ على التوافق مع التكامل الحالي مع Prometheus.

v6.15.0

WProofreader core الإصدار 6.15.0 يضيف دعمًا لتصحيح الأخطاء الإملائية في اللغة التايلاندية، ويقدم applyAllSuggestions طريقة لتطبيق كل تصحيح مقترح في عملية واحدة، وتحسين وصف الاقتراحات عبر محركات قواعد اللغة والتدقيق اللغوي القائمة على الذكاء الاصطناعي. كما يضم هذا الإصدار توسيعًا للقواميس بأكثر من 1,200 كلمة ومصطلح جديدًا في تسع لغات، وتحديثًا لقواعد الإملاء الألمانية، بالإضافة إلى تحسينات في عملية إنشاء Docker وإصلاحات لعدة ثغرات أمنية.

📝 ملخص سريع

  • تمت إضافة دعم تصحيح الأخطاء الإملائية للغة التايلاندية.
  • تم تقديم applyAllSuggestions طريقة لتطبيق كل تصحيح مقترح في مستند ما باستدعاء واحد.
  • تحسين تصنيف الاقتراحات عبر محركات التدقيق النحوي ومحركات التدقيق القائمة على الذكاء الاصطناعي، بما في ذلك ميزة جديدة للكشف عن المشكلات المتعلقة بالأسلوب.
  • قواميس موسعة تضم أكثر من 1,200 كلمة ومصطلح جديد في تسع لغات.
  • أصبحت اقتراحات الفواصل المفقودة معطلة بشكل افتراضي في العناوين وعناصر القوائم.
  • تم تحسين توافق عمليات إنشاء Docker عبر Kaniko وBuildah ومنشئ Docker الكلاسيكي.
  • تصحيحات أمنية. تم تحديث مكتبات Rangy وjackson-databind وch.qos.logback لمعالجة CVE-2023-26102، CVE-2026-54515و CVE-2026-9828، و CVE-2026-10532.

نواة WProofreader JS (الإصدار 3.44.6097)

  • تمت إضافة applyAllSuggestions أمر يقبل جميع التصحيحات المقترحة دفعة واحدة، بدلاً من تطبيقها واحدًا تلو الآخر. وهو متاح الآن للمطورين لإضافته إلى إعداداتهم؛ وسيتم توفير زر جاهز للاستخدام في الواجهة في إصدار قادم.
  • لم تعد تذكيرات «فترة الغياب» تظهر في العناوين وعناصر القوائم بشكل افتراضي، مما يقلل من عدد الاقتراحات التي لا تنطبق في هذه السياقات. مراجعة disabledRulesPerEnvironment في وثائق التكوين لمزيد من المعلومات.
  • تم تحسين طريقة التعرف على الاختصارات الألمانية التي تحتوي على مسافات وأحرف كبيرة (مثل z. B.)، بحيث لم تعد تؤدي إلى ظهور اقتراحات غير صحيحة بشأن استخدام الأحرف الكبيرة بعدها.
  • تم تحسين طريقة التعامل مع خيار «تجاهل أسماء النطاقات». يتم الآن تجاهل أسماء النطاقات بشكل ثابت، حتى في الحالات التي كانت تُعتبر فيها سابقًا أخطاء إملائية. لمزيد من التفاصيل، راجع وثائق خيارات تجاهل الأخطاء الإملائية.

خادم التطبيقات

  • تمت إزالة رسائل التحقق من صحة الأجهزة التي عفا عليها الزمن من سجلات خادم التطبيقات. لم تُستخدم الأجهزة في عملية التحقق من صحة الترخيص منذ فترة، لكن الرسائل ذات الصلة ظلت موجودة وكان من الممكن أن تسبب لبسًا أثناء عملية استكشاف الأخطاء وإصلاحها.

النشر

  • تحسين موثوقية عمليات إنشاء Docker عبر Kaniko وBuildah وأداة إنشاء Docker الكلاسيكية، بما في ذلك الإعدادات التي تتجاوز القيم باستخدام --build-arg. أصبحت معلمات البناء تُنقل الآن بشكل صحيح إلى كل مرحلة من مراحل عملية البناء متعددة المراحل، مما يعالج الحالات التي كانت فيها المراحل اللاحقة لا تستطيع الوصول إليها.

التدقيق اللغوي باستخدام الذكاء الاصطناعي

قواعد اللغة

  • أصبحت الاقتراحات الصادرة عن محرك القواعد النحوية التابع لجهة خارجية تُصنف الآن بشكل صحيح على أنها مشكلات نحوية أو إملائية أو أسلوبية، وبالتالي يتم تمييزها بالطريقة الصحيحة. في السابق، كانت جميع الاقتراحات الصادرة عن هذا المحرك تظهر على أنها مشكلة نحوية، حتى عندما لا تكون كذلك.
  • تم تحديث LanguageTool إلى الإصدار الصادر في 14 يوليو 2026.
  • تحسين التعرف على الكلمات الألمانية التي يمكن أن تُستخدم كفعل أو صفة، مثل كلمة «strukturierte». في السابق، كان يتم التعرف على بعض هذه الكلمات كأفعال فقط، مما قد يؤدي إلى قيام «قاعدة الفاصلة» بتفسير بنية الجملة بشكل خاطئ واقتراح حذف فاصلة صحيحة عن طريق الخطأ.
  • تم تحسين الاتساق بين أسماء القواعد بحيث أصبح تفعيل أو تعطيل قاعدة نحوية معينة يتم الآن بالطريقة نفسها، بغض النظر عن محرك التدقيق الذي يتولى معالجتها.

التهجئة

  • أصبحت اللغة الهولندية الآن تعترف بالكلمات التي تحتوي على علامات الفصل، مثل ‘s-Hertogenbosch، باعتبارها مكتوبة بشكل صحيح.
  • اقتراحات إملائية محسّنة للاختصارات الألمانية التي تتطلب وجود مسافة بين جزأيها، مثل تصحيح «z.B.» إلى «z. B.»
  • تمت إضافة أكثر من 640 كلمة ومصطلحًا جديدًا باللغات الإنجليزية والألمانية والإسبانية والأوكرانية والبلغارية والهولندية والتايلاندية واليونانية والبرتغالية. وتغطي هذه الكلمات والمصطلحات المفردات اليومية بالإضافة إلى المجالات المتخصصة مثل العلوم والأعمال والتكنولوجيا.
  • تم توسيع القاموس المشترك بين اللغات بإضافة أكثر من 30 اسمًا علميًا واختصارًا جديدًا، بما في ذلك أسماء الشركات والمنتجات والمنظمات، مثل «Canon, Ltd» و «Rakuten». بالإضافة إلى ذلك، تمت إضافته كقاموس إضافي للتدقيق الإملائي باللغة اليونانية.
  • تمت إضافة 550 مصطلحًا طبيًّا جديدًا باللغات الإنجليزية والألمانية والإسبانية، بما في ذلك الاختصارات وأسماء الإجراءات، مثل «hepatoscopy» و«Unkovertebralgelenke» و«USG».
  • تم توسيع نطاق دعم اللهجات الإنجليزية بإضافة 17 زوجًا جديدًا من اللهجات، مثل «hematoporphyrin» (الأمريكية) و«haematoporphyrin» (البريطانية).
  • تم تحسين أكثر من 40 اقتراحًا للتهجئة والتصحيح التلقائي في اللغات الإنجليزية والإسبانية والأوكرانية والبلغارية والكتالونية، بالإضافة إلى القاموس المشترك بين اللغات. وتركز هذه الاقتراحات على الأخطاء الإملائية الشائعة والأسماء الخاصة والاختصارات، مثل llm → LLM.

الإكمال التلقائي

  • أصبح نظام الإكمال التلقائي الآن يوقف عرض أي اقتراحات عندما يحتوي النص المكتوب على كلمات يمكن اعتبارها ألفاظًا بذيئة شديدة.

اللغات

  • تم تفعيل دعم تصحيح الإملاء للغة التايلاندية.

🛡 الأمن

  • مكتبة Rangy: قمنا بدمج التصحيح الأصلي الخاص بـ CVE-2023-26102 في نسختنا المعدلة من مكتبة Rangy المستخدمة في SCAYT3، مما أدى إلى سد الثغرة الأمنية مع الحفاظ على توافقها مع نسختنا المعدلة.
  • jackson-databind: قمنا بتحديث jackson-databind إلى الإصدار 2.18.9 لإصلاح الثغرة الأمنية CVE-2026-54515. ويؤثر هذا التحديث على المكونات التي تعتمد على jackson-databind، سواء بشكل مباشر أو غير مباشر.
  • ch.qos.logback: قمنا بتحديث ch.qos.logback من الإصدار 1.5.25 إلى الإصدار 1.5.35 لإصلاح ثغرتين أمنيتين تتعلقان بعملية إزالة التسلسل، وهما CVE-2026-9828 و CVE-2026-10532. ويؤثر هذا التحديث على المكونات التي تعتمد على ch.qos.logback، سواء بشكل مباشر أو غير مباشر.

🐞 إصلاحات الأخطاء

  • محرك التدقيق الإملائي: الكلمات المطولة، مثل loooooooooooong، أسفرت عن ظهور عبارة «لا توجد اقتراحات»
  • محرك التدقيق الإملائي: أدت سلاسل الأحرف غير المفهومة، مثل fjkdkdjshkhfdk، إلى ظهور اقتراحات لكلمات حقيقية لا علاقة لها بالموضوع

v6.14.0

أصدرت النسخة الأساسية من WProofreader v6.14.0 محرك التدقيق اللغوي القائم على الذكاء الاصطناعي v3.1.0 للغة الإسبانية، ووسعت نطاق دعم مساعد الكتابة القائم على الذكاء الاصطناعي ليشمل اللغة اليونانية، وحسّنت عملية حساب عدد الكلمات متعددة اللغات، ووسعت نطاق تغطية القواميس بإضافة أكثر من 7,800 كلمة جديدة، وعززت عملية التحقق من صحة القواميس المخصصة ومعالجة علامة الفاصلة العليا، كما تضمنت تحديثات أمنية لتبعيات Jackson.

📝 ملخص سريع

  • تم إصدار الإصدار 3.1.0 من محرك التدقيق اللغوي القائم على الذكاء الاصطناعي للغة الإسبانية ، والذي يتميز بجودة تصحيح محسّنة في مجالات القواعد النحوية، واستخدام الكلمات، وأشكال الأفعال، وحروف الجر، وكتابة الأرقام، وحالات الخلط الشائعة بين الكلمات
  • تمت إضافة دعم اللغة اليونانية إلى مساعد الكتابة الذي يعمل بالذكاء الاصطناعي
  • مساعد كتابة باللغة الإسبانية مدعوم بالذكاء الاصطناعي تم تحسينه من خلال الانتقال من نماذج شركة «أنثروبيك»
  • قواميس موسعة تضم أكثر من 2,700 كلمة جديدة في لغات متعددة، بما في ذلك الاختصارات والأسماء الخاصة والمصطلحات الفنية والمصطلحات اللغوية
  • تحسين عملية حساب عدد الكلمات ومعالجتها لعدة لغات، بما في ذلك اليابانية والصينية
  • تمت إضافة دعم للواصلة في أسماء القواميس، وتوسيع نطاق معالجة الفاصلة العليا في القواميس المخصصة وقواميس المستخدمين
  • تم تحديث LanguageTool إلى الإصدار الصادر في 12 يونيو 2026
  • تحسين تغطية القاموس للغة الدنماركية والإنجليزية النيوزيلندية
  • تحديثات الأمان. تم تحديث مكتبتَي jackson-core و jackson-databind لمعالجة الثغرتين CWE-770 و CVE-2026-54513

⚠️ تغيير مهم

  • تم تحسين عملية حساب عدد الكلمات لعدة لغات، بما في ذلك اللغات التي لا تحتوي على مسافات. في السابق، كان يتم تحديد الكلمات باستخدام المسافات وعلامات الترقيم، مما أدى إلى احتساب جمل كاملة في لغات مثل اليابانية والصينية على أنها كلمة واحدة. يستخدم WProofreader الآن تقسيمًا قائمًا على ICU لحساب المورفيمات لهذه اللغات، مما يوفر إحصاءات أكثر دقة لعدد الكلمات وإحصاءات لغوية. على سبيل المثال، يتم الآن حساب كلمة わかんない على أنها 3 مورفيمات (わか / ん / ない)، بدلاً من مورفيم واحد.

🛠 التحسينات

نواة WProofreader JS (الإصدار 3.43.6079)

  • تمت إضافة نسخة باللغة اليونانية من إخلاء المسؤولية الخاص بمساعد الكتابة بالذكاء الاصطناعي.
  • تم تحديث عملية التحقق من صحة كلمات قاموس المستخدم والقاموس المخصص لدعم جميع أحرف الفاصلة العليا المسموح بها.

التدقيق اللغوي باستخدام الذكاء الاصطناعي

  • تم إصدار الإصدار 3.1.0 من محرك التدقيق اللغوي القائم على الذكاء الاصطناعي للغة الإسبانية. تم تحسين جودة التصحيح فيما يتعلق بصيغة الشرط، وأزمنة الأفعال، والأفعال الانعكاسية، وحروف الجر، وتوافق الصفات والظروف، وتوافق المفعول الماضي، والتراكيب الجزئية، وكتابة الأرقام، وحالات الخلط الشائعة بين الكلمات، بما في ذلك «ser» و«haber». راجع الوثائق للحصول على مزيد من التفاصيل حول تحسينات التدقيق اللغوي في اللغة الإسبانية.
  • تحسين أداء التدقيق اللغوي القائم على الذكاء الاصطناعي عبر اللغات المختلفة في النصوص التي تحتوي على تنسيقات الأرقام الفوقية والتحتية.

قواعد اللغة

  • تم تحديث LanguageTool إلى الإصدار الصادر في 12 يونيو 2026.

مساعد الكتابة بالذكاء الاصطناعي

التهجئة

  • قواميس موسعة تضم أكثر من 2,700 كلمة جديدة باللغات الإنجليزية والألمانية والإسبانية والأوكرانية والدنماركية والبرتغالية، وتشمل الاختصارات والمصطلحات التقنية والكلمات الشائعة والأسماء الخاصة والمصطلحات اللغوية. 
  • كما أُضيفت إلى القواميس الألمانية أكثر من 4,600 صيغة جديدة من الأسماء التي تحتوي على حرف -s ربطي، بالإضافة إلى الصيغ المركبة بواسطة واصلة، مثل Fort-. 
  • مصطلحات طبية موسعة للغات الإنجليزية والألمانية والإسبانية تضم 495 مصطلحًا جديدًا، تشمل الصفات الطبية وأسماء الأمراض والاختصارات، مثل «بالميتويل كارنيتين» و«اختبار فينكلشتاين» و«ديستروفيكا».
  • تحسين تغطية اللهجات في اللغة الإنجليزية بإضافة أزواج كلمات جديدة، مثل preprosthetic مقابل pre-prosthetic. 
  • تم تحسين معالجة النصوص بالألمانية من خلال السماح باستخدام الواصلات في بداية الكلمات مع تقييد استخدام النقطتين داخل الكلمات، مثل -konzepte.
  • قواعد محسّنة للتهجئة واقتراحات التصحيح التلقائي للأخطاء الإملائية الشائعة والصوتية في اللغتين الإنجليزية والإسبانية، مثل: Afroasiatic → Afro-Asiatic.

القواميس المخصصة وقواميس المستخدمين

  • تحسين عملية التحقق من صحة أسماء القواميس الخاصة بالمستخدم. أصبحت أسماء القواميس تدعم الآن الواصلات وتقبل الأحرف اللاتينية ASCII والأرقام وعلامات التسطير السفلية والواصلات. تم تحديث قواعد التحقق من الصحة ورسائل الخطأ من أجل معالجة أكثر اتساقًا للأسماء غير الصحيحة.
  • تدعم القواميس المخصصة وقواميس المستخدمين الآن إضافة كلمات تحتوي على أنواع مختلفة من الفواصل العليا، مثل l’acqua، l’acqua، وما إلى ذلك .

الأسلوب

  • مواصلة تحسين عملية تصفية اقتراحات الإكمال التلقائي التي تحتوي على عبارات حساسة أو غير متوقعة أو تمييزية.
  • تمت إضافة دعم لاقتراحات الأنماط والأنماط التي تبدأ بمسافة، كما هو الحال في اللغة الألمانية*in → (m/w/d) ،بحيث يكون هناك نمط واحد لـ Arzt*in → Arzt (m/w/d)، و Professor*in → Professor (m/w/d).

اللغات

  • تم تعديل قاموس Hunspell الدنماركي لتقليل عدد الكلمات المركبة التي يتم تصنيفها خطأً على أنها أخطاء. المصدر: WebSpellChecker hunspell-dictionaries-modifications
  • تم توسيع نطاق المفردات الإنجليزية النيوزيلندية من خلال ربط قاموس «Hunspell» للغة الإنجليزية الأسترالية الإصدار 4.0.7 من تأليف ماركو بينتو، وذلك لتوفير تغطية إضافية للمفردات المشتركة.
    المصدر: https://github.com/marcoagpinto/aoo-mozilla-en-dict 

🛡 الأمن

  • تحديث jackson-core: تم تحديث jackson-core إلى الإصدار 2.18.7 لمعالجة CWE-770. النطاق: المكونات التي تعتمد على jackson-core (بشكل مباشر أو غير مباشر) ضمن حزمة langtool/libs.
  • تحديث jackson-databind: تم تحديث jackson-databind إلى الإص دار 2.18.8 لمعالجة CVE-2026-54513. النطاق: المكونات التي تعتمد على حزمة langtool/libs التي تحتوي على jackson-databind (بشكل مباشر أو غير مباشر).

🐞 إصلاحات الأخطاء

  • نواة WProofreader JS: ظهور علامات نقطية سوداء غير متوقعة في واجهة مستخدم WProofreader (WordPress 7.0، المكون الإضافي Guttenberg). تم حل تعارض في الأنماط كان يتسبب في عرض علامات القوائم الافتراضية في مكونات واجهة WProofreader.

v6.13.1

يعمل الإصدار الأساسي v6.13.1 من WProofreader على تحسين التوافق مع المحررات المستضافة داخل حاويات Shadow DOM من خلال إصلاح وظائف الكشف التلقائي عن المحرر، والتهيئة، والبحث التلقائي، كما يعزز أمان صورة Docker الخاصة بـ WProofreader من خلال إصلاحات الثغرات الأمنية في OpenNLP وNetty، ويقوم بتحديث تقرير VAPT.

📝 ملخص سريع

  • تحسين التوافق مع المحررات المستضافة داخل حاويات Shadow DOM، بما في ذلك الكشف التلقائي عن المحرر، والتهيئة، وتحميل الأنماط
  • تم إصلاح وظيفة البحث التلقائي في بيئات Shadow DOM
  • تم تحديث مكونات OpenNLP وNetty في صورة Docker الخاصة بـ WProofreader لمعالجة سبع ثغرات أمنية تم الإبلاغ عنها
  • تم تحديث تقرير VAPT إلى الإصدار 6.13.1 وتحسين التوافق مع أداة فحص الثغرات الأمنية

🛠 التحسينات

نواة WProofreader JS (الإصدار 3.42.6067)

  • تحسين دعم Shadow DOM. تم إصلاح عملية الكشف التلقائي عن المحررات وتهيئة أداة التدقيق اللغوي للعناصر القابلة للتحرير الموجودة داخل حاويات Shadow DOM. أصبحت أداة WProofreader الآن قادرة على الكشف بشكل صحيح عن المحررات النشطة، والحفاظ على مثيلات المحررات عندما تظل متصلة بالصفحة، وتحميل أنماط واجهة المستخدم والترميز المطلوبة داخل بيئات Shadow DOM. 

🛡 الأمن

  • تصحيحات أمنية لـ OpenNLP: تم دمج إصدار مُعدَّل من OpenNLP 1.9.4 يتضمن تصحيحات مُطبَّقة بأثر رجعي على الثغرات الأمنية CVE-2026-40682 و CVE-2026-42027 و CVE-2026-42440، مع الحفاظ على التوافق مع LanguageTool ومعالجة الثغرات الأمنية المبلغ عنها. النطاق: مكونات OpenNLP التي يستخدمها LanguageTool بشكل غير مباشر والمضمنة في صورة Docker الخاصة بـ WProofreader. 
  • تحديث Netty: تم تحديث إصدار Netty المضمّن من 4.1.133.Final إلى 4.1.135.Final لمعالجة الثغراتالأمنية التالية في : CVE-2026-44249، وCVE-2026-45416، وCVE-2026-45674، وCVE-2026-47691. النطاق: مكونات Netty التي يستخدمها LanguageTool بشكل غير مباشر والمضمنة في صورة Docker الخاصة بـ WProofreader.
  • VAPT: تحديث التقرير إلى الإصدار 6.13.1

v6.13.0

يقوم الإصدار الأساسي v6.13.0 من WProofreader بترحيل عمليات مساعد الكتابة بالذكاء الاصطناعي إلى نماذج جديدة واستعادة دعمه لـ Google Docs، كما يحسّن جودة التدقيق اللغوي والإكمال التلقائي القائمين على الذكاء الاصطناعي، ويوسّع القواميس متعددة اللغات بإضافة أكثر من 1400 كلمة، ويضع حدودًا للقواميس المخصصة ومجموعات أدلة الأسلوب، ويحدّث القواميس الأوكرانية والفنلندية، ويقدم تحديثًا أمنيًا.

📝 ملخص سريع

  • تم ترحيل نماذج مساعد الكتابة بالذكاء الاصطناعي المتعددة اللغات إلى بدائل من «أمازون» و«جوجل» عقب إيقاف دعم نماذج «كلود» من «أنثروبيك»، وذلك بهدف تحسين الأداء
  • تم تحديث القاموسين الأوكراني والفنلندي 
  • قواميس موسعة تضم أكثر من 1,400 كلمة جديدة باللغات الإنجليزية والألمانية والإسبانية والبرتغالية، تشمل الكلمات الشائعة والمصطلحات الطبية وأسماء علمية إضافية واختصارات
  • تحسين جودة التهجئة من خلال معالجة أفضل للكلمات اليونانية المكتوبة بأحرف كبيرة
  • تحسين عملية تصفية اقتراحات الإكمال التلقائي التي تحتوي على لغة حساسة أو تمييزية
  • تحديث إرشادات الأسلوب لتشمل القواعد الجديدة المتعلقة بالمصطلحات الإنجليزية المستخدمة في اللغة الإسبانية
  • تحسين جودة التدقيق اللغوي باستخدام الذكاء الاصطناعي في جميع النماذج المدعومة، وتعزيز الإصدار 3.0 من التدقيق اللغوي باللغة الإسبانية باستخدام الذكاء الاصطناعي لتوفير تصحيحات أكثر موثوقية.
  • تم استعادة توافق مساعد الكتابة القائم على الذكاء الاصطناعي مع Google Docs
  • تحديث أمني. تم تحديث OpenTelemetry لمعالجة الثغرة الأمنية CVE-2026-45292

🛠 التحسينات

نواة WProofreader JS (الإصدار 3.42.6057)

  • تحسين التوافق مع Google Docs. تم إصلاح المشكلات التي كانت تمنع مساعد الكتابة بالذكاء الاصطناعي من العمل بشكل صحيح في Google Docs.

التدقيق اللغوي باستخدام الذكاء الاصطناعي

  • تحسين جودة التدقيق اللغوي باستخدام الذكاء الاصطناعي في اللغات الإنجليزية والألمانية والإسبانية فيما يتعلق بالتعامل مع علامات الترقيم والمسافات، بما في ذلك الفواصل العشرية والشرطات القصيرة وعلامات الترقيم المحيطة بالنص الذي تم تصحيحه.
  • تم تحسين دقة تصحيح اللغة الإسبانية من خلال تجنب الضمائر الزائدة وعلامات الترقيم غير الضرورية ورموز الدرجات والأقواس المربعة والاقتراحات المكررة.
  • تحسين جودة الاقتراحات باللغة الألمانية من خلال تقييد حذف الكلمات في نهاية الجمل الألمانية.

مساعد الكتابة بالذكاء الاصطناعي

  • تم ترحيل مساعد الكتابة باللغة الإنجليزية المدعوم بالذكاء الاصطناعي من Anthropic Claude Haiku 3 عقب إيقاف دعمه. لمزيد من المعلومات، يرجى الاطلاع على الوثائق الخاصة بالنماذج الحالية باللغة الإنجليزية.
  • تم ترحيل سير عمل محدد لمساعدات الكتابة القائمة على الذكاء الاصطناعي بال لغات النرويجية والإيطالية والإسبانية والدنماركية من «Anthropic Claude Sonnet 4» عقب إيقاف دعمها.
  • تم تحديث المطالبات وترحيل مساعد الكتابة بالذكاء الاصطناعي باللغتين الألمانية والأوكرانية من Anthropic Claude Haiku 4.5 لتحسين الأداء.
  • تم تحسين تلميحات مساعد الكتابة المدعوم بالذكاء الاصطناعي باللغات الهولندية والسويدية والبرتغالية والبولندية، مما يضمن نتائج أكثر اتساقًا في إعادة الصياغة وتعديل النبرة وتقصير النص وتوسيعه.

التهجئة

  • تحسين معالجة الكلمات اليونانية المكتوبة بأحرف كبيرة بالكامل، مثل ΕΙΔΗΣΗ.
  • قواميس موسعة تضم أكثر من 1,000 كلمة جديدة في اللغات الإنجليزية والألمانية والإسبانية والبرتغالية، وتغطي الاختصارات واللواحق وعلم الأحياء والكلمات الشائعة والاختلافات اللهجية والأطعمة وعلم اللغة والموسيقى والأسماء الخاصة واللغة العامية والتكنولوجيا.
  • تم إثراء القواميس المشتركة بين اللغات بأكثر من 30 اسمًا خاصًّا واختصارًا، مثل Googlebot وISO.
  • تم تعزيز المصطلحات الطبية باللغتين الإنجليزية والإسبانية بإضافة 471 كلمة جديدة تشمل المصطلحات الطبية والقانونية والاختصارات والمفردات ذات الصلة.
  • تم توسيع نطاق تغطية اللهجات الإنجليزية بإضافة أزواج كلمات لهجية جديدة، مثل «radiolabeled » مقابل «radiolabelled».
  • قواعد اقتراحات محسّنة للأخطاء الإملائية الشائعة في اللغتين الإنجليزية والإسبانية، مثل «gritings» → «greetings».

قاموس مخصص

  • تم إضافة قيود على عدد القواميس المخصصة وفقًا لخطة الاشتراك. بحد أقصى 250 قاموسًا في حالة الاستضافة الذاتية.

الأسلوب

  • تم إضافة قيود على عدد مجموعات أدلة الأنماط وفقًا لخطة الاشتراك. بحد أقصى 250 مجموعة في حالة الاستضافة الذاتية.
  • جعل المعلمة «collection» إلزامية لأي إجراءات تتعلق بقواعد دليل الأسلوب باستخدام واجهة برمجة التطبيقات (API)
  • تم تحديث دليل الأسلوب الإسباني ليشمل قواعد جديدة تتعلق بالمصطلحات المستمدة من اللغة الإنجليزية، مثل «download» و«shopping center» وما إلى ذلك.
  • تمت إضافة إمكانية استخدام جزء من حقل «النمط» في حقل «الاقتراحات». على سبيل المثال، Lehrer → Lehrer*in

الإكمال التلقائي

  • تحسين عملية تصفية اقتراحات الإكمال التلقائي التي تحتوي على مصطلحات حساسة أو غير متوقعة أو تمييزية، مثل «الحرب» و«المخدرات» وما إلى ذلك.

اللغات

  • تم تحديث قاموس Hunspell الأوكراني (uk_UA) إلى الإصدار 6.8.0 (23 أبريل 2026) من إعداد Rysin, A. و Starko, V.، والذي تضمن توسيعًا للقاموس ليشمل أكثر من 12,000 مدخل. المصدر: https://github.com/brown-uk/dict_uk/releases#release-v6.8.0 
  • تم تحديث قاموس Hunspell للغة الفنلندية (fi_FI) إلى الإصدار v0.2 (6 ديسمبر 2023) بواسطة Voiko، مما أدى إلى توسيع نطاق تغطية المفردات بشكل كبير في المجالات التقنية والطبية والأسماء الخاصة. المصدر: https://github.com/fginter/hunspell-fi/releases/tag/0.2 

🛡 الأمن

  • تحديث OpenTelemetry: تم تحديث OpenTelemetry إلى الإصدار 1.62.0 لمعالجة CVE-2026-45292. النطاق: المكونات التي تعتمد على حزمة opentelemetry (بشكل مباشر أو غير مباشر) ضمن حزمة langtool/libs.

🐞 إصلاحات الأخطاء

  • WProofreader JS core: مساعد الكتابة القائم على الذكاء الاصطناعي لا يعمل في Google Docs
  • توقف مساعد الكتابة بالذكاء الاصطناعي عن العمل في الإضافة المجانية المخصصة للكشف التلقائي عن اللغة

v6.11.0

إصدار WProofreader core v6.11.0

يعمل برنامج WProofreader الإصدار 6.11.0 على تبسيط عملية النشر على خادم خاص من خلال إلغاء متطلبات اسم النطاق، ويقدم خيارات جديدة في النواة JavaScript للتخطيطات القابلة للتحجيم والتحكم في شارة RTL، ويغير مجموعة أدوات التدقيق الافتراضية للغة الإنجليزية إلى ai_lt_hs1 لمستخدمي الخدمة السحابية، يوسع القواميس بإضافة أكثر من 9,700 مدخل جديد، ويُحدّث محرك القواعد النحوية بتحسينات كبيرة في اللغة الكاتالونية، ويصلح ثغرة أمنية.

اطلع على ملخص المقال أدناه.

📝 ملخص سريع

  • [السحابة] تم تغيير الإعدادات الافتراضية لفحص النص باللغة الإنجليزية إلى ai_lt_hs1. يجمع بين محرك التدقيق اللغوي القائم على الذكاء الاصطناعي ومحركات القواعد النحوية والإملائية الخوارزمية لتحسين الدقة
  • لم يعد التثبيت على خادم خاص يتطلب اسم نطاق — إعداد مبسط لأنظمة Docker وWindows وLinux
  • خيارات جديدة هي «enableScale » و«disableBadgeRTLMirroring» في النواة الأساسية لـ WProofreader JS
  • قواميس موسعة تضم أكثر من 9,700 مدخل جديد باللغات الإنجليزية والألمانية والإسبانية والأوكرانية والروسية
  • قاموس ألماني موسع يضم أكثر من 13,550 صيغة من الكلمات المركبة للأسماء المؤنثة التي تنتهي بـ «Fuge-s»
  • تم تحديث محرك القواعد النحوية التابع لجهة خارجية، حيث أُجريت تحسينات كبيرة على اللغة الكاتالونية، بالإضافة إلى صقل القواعد الخاصة باللغات الألمانية والإسبانية والبرتغالية والأوكرانية والإنجليزية
  • أصبحت القواميس المخصصة للمستخدمين تقبل الآن الكلمات الموجودة بالفعل في قواميس التدقيق الإملائي الأساسية
  • تصحيح أمني. تم تحديث jackson-core لمعالجة الثغرة GHSA-72hv-8253-57qq

🛠 التحسينات

نواة WProofreader JS (الإصدار 3.39.6037)

  • تم إدخال خيار جديد باسم enableScale. يتيح هذا الخيار دعم تحويلات التكبير/التصغير في CSS المطبقة على العناصر الأصلية. عند تفعيله، يقوم WProofreader باكتشاف قيمة التكبير/التصغير للعنصر الأصلي ويقوم بتعديل عناصر واجهة المستخدم وفقًا لذلك، مما يضمن بقاء عناصر التمييز وعناصر الواجهة محاذاة بشكل صحيح عند تغيير حجم المحتوى المحيط. هذا الخيار معطل افتراضيًا.
  • تم إدخال خيار جديد باسم disableBadgeRTLMirroring. يعمل هذا الخيار على تعطيل انعكاس موضع الشارة تلقائيًا للغات التي تُكتب من اليمين إلى اليسار (RTL) مثل اللغة العربية. عند تفعيله، تحتفظ الشارة بموضعها المُعد مسبقًا بدلاً من أن يتم انعكاسها تلقائيًا وفقًا لاتجاه النص. وتبقى خيارات تحديد موضع الشارة يدويًّا دون تغيير. هذا الخيار معطّل افتراضيًّا.

النشر

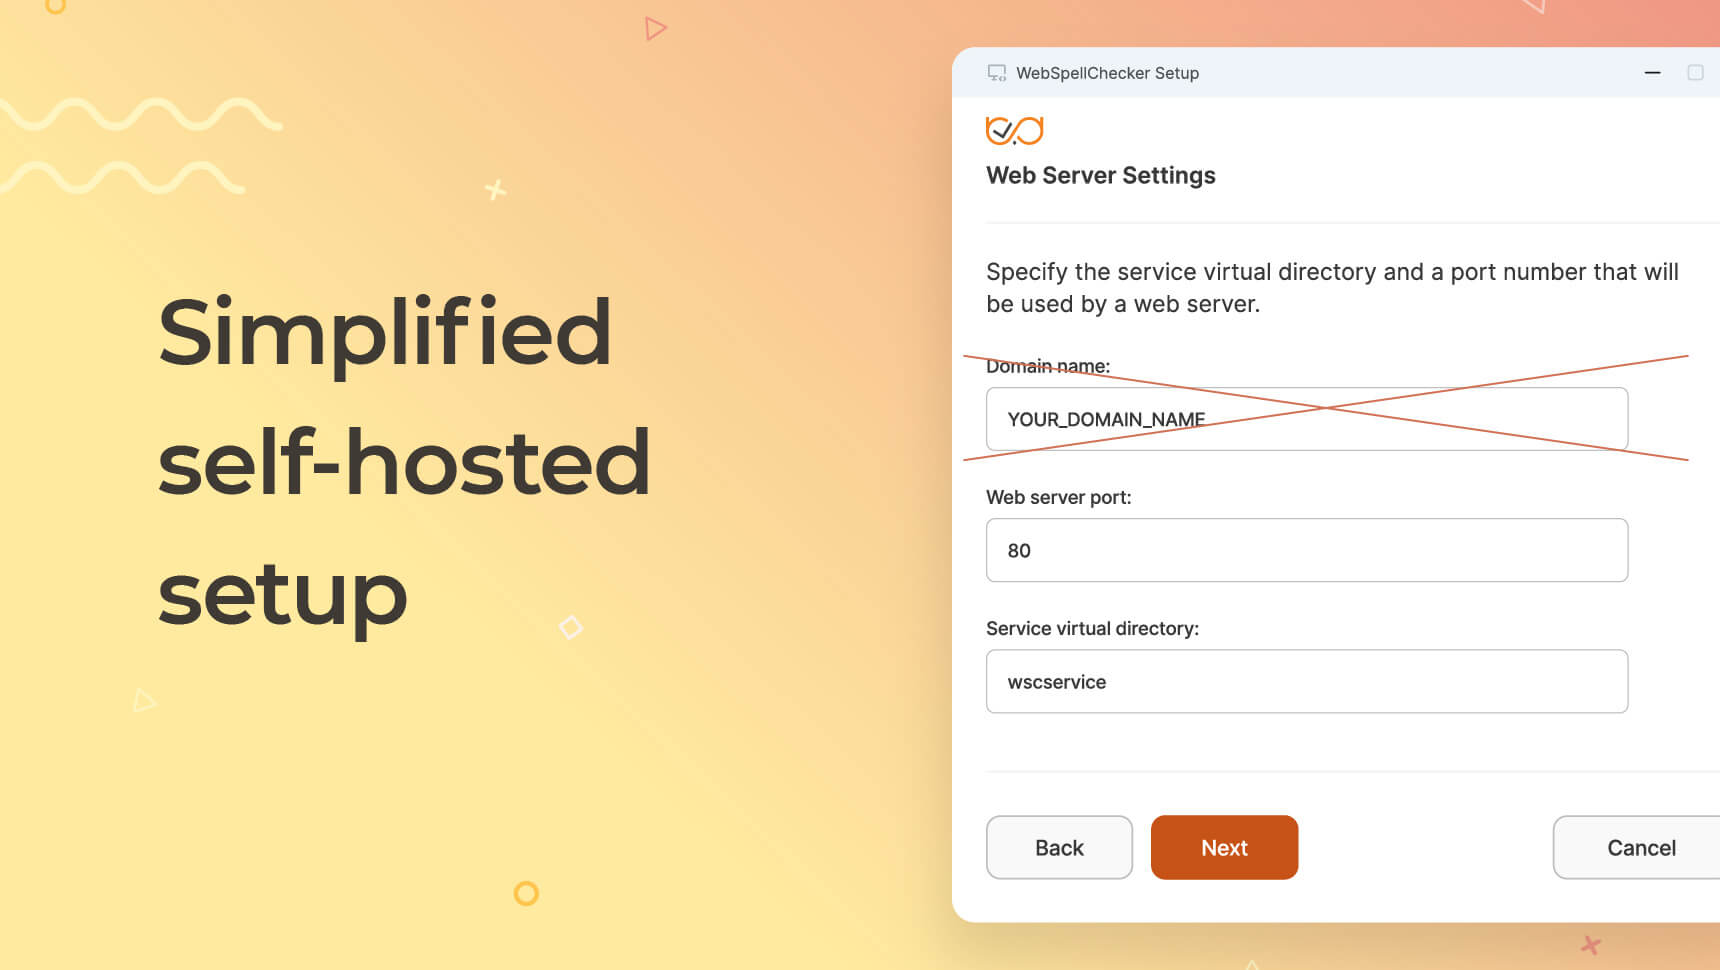
  • تم إلغاء شرط تحديد اسم نطاق أثناء التثبيت بالنسبة للإصدار المُستضاف ذاتيًا. وهذا يُبسط عملية الإعداد الأولي في بيئات Docker وWindows وLinux:
    • Docker. تمت إزالة WPR_DOMAIN_NAME المعلمة. تمت إضافة دعم لتشغيل الحاوية من المسار الجذري (/) عبر WPR_VIRTUAL_DIR. تعرف على المزيد حول إعدادات دوكر.
    • مخطط Helm. تم تحديثه إلى الإصدار 1.3.1. أصبح من الممكن ترك الإعداد فارغًا virtualDir (/)، تم حذفها WPR_DOMAIN_NAME من extraEnv مثال، وتم تحديثه appVersion إلى 6.11.0.0. تعرف على المزيد حول خريطة هيلم.
    • برامج التثبيت الخاصة بنظامي ويندوز ولينكس. أصبح خادم الويب الآن يستقبل الطلبات على أي نطاق بشكل افتراضي، مما يلغي إحدى خطوات الإعداد الشائعة.

خادم التطبيقات

  • [السحابة] تم تغيير الإعدادات الافتراضية لفحص النص باللغة الإنجليزية إلى ai_lt_hs1. يجمع هذا الإعداد بين محرك التدقيق اللغوي القائم على الذكاء الاصطناعي ومحرك القواعد النحوية الخوارزمي (LanguageTool) ومحرك التدقيق الإملائي الخوارزمي (Hunspell) مع اقتراحات إملائية لتحسين الدقة. في السابق، كان الإعداد الافتراضي (ai_lt_hs0) تضمنت برنامج «Hunspell» للكشف عن الأخطاء، ولكن دون اقتراحات إملائية. إذا لزم الأمر، يمكن استعادة السلوك السابق عن طريق ضبط checkKit خيار لـ ai_lt_hs0.
  • تحسين تسجيل الأخطاء. يقدم خادم التطبيق الآن رسائل أكثر تفصيلاً في حالة فشل تحميل قواميس Hunspell، أو في حالة عدم وجود نموذج لغة قائم على الذكاء الاصطناعي، أو عند عدم العثور على نموذج n-gram. وهذا يسهل تشخيص مشكلات التكوين أثناء النشر.
  • تمت إضافة إمكانية ضبط الحد الأقصى لطول التسلسل في إعدادات نموذج الذكاء الاصطناعي.
  • تم تحسين معالجة مسارات الملفات عبر خادم التطبيق بحيث يتم استخدام المسارات المطلقة بدلاً من البحث في دليل العمل الحالي. ويؤدي ذلك إلى حل المشكلات التي تحدث عندما يعمل خادم التطبيق كخدمة systemd على نظام لينكس.

قواعد اللغة

  • تم تحديث محرك القواعد النحوية التابع لجهة خارجية، حيث أُجريت تحسينات على عدة لغات.
    • الكاتالونية. تحديث كبير يتضمن نظامًا جديدًا للتعرف على الأسماء الخاصة يقلل من الأخطاء الإملائية الزائفة في الأسماء التي ظهرت سابقًا في النص، واقتراحات محسّنة لاستبدال الأفعال مع معالجة أفضل للضمائر، وقاموسًا إملائيًا جديدًا متعدد الرموز لتحسين اقتراحات تهجئة الكلمات المتعددة، ودعمًا إضافيًا للتراكيب السببية (مثل:«al no + صيغة المصدر » → «com que…»)، وتحديث قاموس أجزاء الكلام الكاتالوني إلى الإصدار 3.3، وتوسيع قواميس التهجئة والكلمات المتعددة، وتحسين تجزئة الجمل باستخدام «fund». اختصار للغة الكاتالونية والإسبانية، بالإضافة إلى تحسينات متنوعة لقواعد إزالة الغموض.
    • الألمانية. تم تحسين قواعد النحو الخاصة بتركيب «nach zu geben»، كما أُضيفت قواعد للتعامل مع تنسيق الأرقام بالألمانية باستخدام الفاصلة النقطية (مثل: 100.000).
    • الإسبانية. تمت إضافة نمط غير مرغوب فيه لاستخدام كلمة «volares» كصفة، وذلك لمنع ظهور اقتراحات غير صحيحة في صيغة الشرط.
    • البرتغالية. تم إجراء تحسينات مهمة في مجال إزالة الغموض، بما في ذلك معالجة أفضل لكلمتي «pela» و«pelas» باعتبارهما حروف جر، وتحسين إزالة الغموض بين الأفعال والأسماء/الصفات، ووضع علامات جديدة قائمة على السياق للفئات الدلالية، وتفعيل القاعدة المتعلقة بالفاصلة الزائدة بعد الشرطة، وتوسيع نطاق قواعد الكلمات المربكة، وإضافة أنماط غير مرغوب فيها فيما يتعلق بالإشارات إلى جبل K2 وجهاز Samsung Galaxy، بالإضافة إلى تحسينات متنوعة في قواعد الأسلوب للبرتغالية البرازيلية.
    • اللغة الأوكرانية. تم تحديث القاموس الصرفي إلى الإصدار 6.7.5، وتوسيع نطاق معالجة الاختصارات (مثل: крим، пом، суч)، وتحسين أنماط أداة تجزئة الكلمات، وإضافة العديد من اقتراحات الاستبدال المرنة، وتوسيع قواعد الاشتقاق، وتحسين إزالة الغموض في حالة النداء وغيرها من التراكيب النحوية.
    • اللغة الإنجليزية. تمت إضافة الكلمات التالية إلى قاموس التدقيق الإملائي: «misgendered»، «misgender»، «misgenders»، «misgendering»، كما تم تحسين معالجة البادئات في اقتراحات التدقيق الإملائي.

التهجئة

  • قواميس موسعة تضم أكثر من 9,700 مدخل جديد في اللغات الإنجليزية والألمانية والإسبانية والأوكرانية والروسية، وتغطي الاختصارات واللواحق وعلم الأحياء والكيمياء والمصطلحات الشائعة والاختلافات اللهجية والمصطلحات الطبية والعسكرية والمصطلحات الحديثة والأسماء الخاصة والتكنولوجيا وغيرها.
  • تم توسيع القاموس الألماني ليشمل أكثر من 13,550 صيغة من الكلمات المركبة التي تنتهي بـ «-Fuge-s» للأسماء المؤنثة المقترنة بشرطة (مثل: Präventions-).
  • تم إثراء القواميس المشتركة بين اللغات بإضافة 125 اسمًا علميًا واختصارًا شائعًا جديدًا.
  • تمت إضافة موارد جديدة باللغة الروسية.
  • تم تنقيح قوائم الكلمات من خلال حذف أكثر من 500 مدخلاً غير صالح أو غير صحيح في اللغات الإنجليزية والإسبانية والألمانية، مع التركيز على الكلمات غير الموجودة، والمصطلحات الطبية غير الصحيحة، والاختصارات غير الصحيحة والأشكال المكتوبة بأحرف كبيرة، والمدخلات غير المتعلقة باللهجات.
  • أنماط تقسيم مُحسَّنة تتضمن 20 قاعدة جديدة لللغتين الإنجليزية والإسبانية، تغطي الأفعال الانعكاسية والكلمات الشائعة والضمائر والظروف، وذلك لمنع التقسيم الخاطئ للكلمات. كما تم تحسين جودة الاقتراحات من خلال استبعاد المصطلحات المسيئة في سياقات معينة وإزالة الاقتراحات غير الصحيحة عبر فئات متعددة.
  • تم تحسين المصطلحات الطبية باللغتين الإنجليزية والإسبانية بإضافة أكثر من 255 مدخلاً جديداً تغطي المصطلحات اللاتينية، والصفات الطبية، وأسماء الأمراض، والاختصارات. كما تم تنقيح قوائم المصطلحات الطبية بحذف أكثر من 230 مدخلاً غير صالح، استهدف ذلك الكلمات غير الصحيحة، وأشكال الاختصارات، والأشكال المكتوبة بأحرف كبيرة.
  • تمت إضافة دعم لنوعين من علامات الفصل في اللغة الكاتالونية (U+2019 و U+0027).

التصحيح التلقائي

  • قواعد محسّنة لتحديد أولويات الأخطاء الإملائية الشائعة في اللغتين الإنجليزية والإسبانية. تحسين عملية تحديد الأولويات في القاموس المشترك بين اللغات.
  • تم تحسين آلية التصحيح من خلال إزالة إدخالات التصحيح التلقائي غير الصحيحة باللغتين الإنجليزية والإسبانية، والتي تستهدف الاقتراحات الخاطئة.

الأسلوب

  • تم تحديث قواعد الأسلوب للغة الإنجليزية بإضافة قواعد جديدة تتناول العبارات المهينة والإهانات المتعلقة بالعرق والأصل العرقي.

قاموس مخصص

  • ابتداءً من الإصدار 6.11.0، أصبح من الممكن إضافة الكلمات الموجودة في قواميس التدقيق الإملائي الأساسية إلى قواميس المستخدم المخصصة أيضًا.

🛡 الأمن

  • تم تحديث مكتبة «jackson-core» المعرضة للخطر (التي يستخدمها محرك القواعد النحوية) إلى الإصدار 2.18.6 لمعالجة الثغرة GHSA-72hv-8253-57qq (التحايل على قيود طول الأرقام في محلل JSON غير المتزامن، مما قد يؤدي إلى حالة محتملة لرفض الخدمة).

🐞 إصلاحات الأخطاء

  • نواة WProofreader JS: يتم تغيير موضع الاقتراحات المميزة عند استخدام المكون الإضافي «Zoom» في CKEditor
  • نواة WProofreader JS: تباين في سلوك التنقل باستخدام لوحة المفاتيح في مربع حوار مساعد الكتابة بالذكاء الاصطناعي في البيئات المختلطة التي تجمع بين الاتجاهين من اليسار إلى اليمين ومن اليمين إلى اليسار
  • محرك التدقيق الإملائي: لا تُعتبر الكلمات المكتوبة باستخدام الفواصل العليا الطباعية صحيحة في اللغة الكاتالونية
  • محرك التدقيق الإملائي: لا يُسمح بقواعد الفصل التي تحتوي على أرقام
  • خادم التطبيقات: لا تعمل وظيفة القواعد المسموح بها بالشكل المتوقع
  • خادم التطبيقات: يفشل Hunspell في حالة عدم العثور على نموذج n-gram
  • دليل الأسلوب: لا يمكن الاطلاع على القواعد الأساسية لدليل الأسلوب
  • دليل الأنماط: تُستخدم المسارات النسبية لملفات دليل الأنماط

v6.10.0

يقدم برنامج WProofreader الإصدار 6.10.0 تحديثًا كبيرًا لنظام ترتيب اقتراحات التدقيق الإملائي، حيث يعتمد على ترتيب أولويات n-gram استنادًا إلى ثلاثيات الحروف (trigrams) للغات الإنجليزية والألمانية والإسبانية، كما يضيف تلميحات الإكمال التلقائي على لوحة المفاتيح، ويُحدَّث محرك القواعد النحوية، ويوسع نطاق دعم اللغات بإضافة موارد للغتين اليونانية والتشيكية، ويصلح ثغرة أمنية.

اطلع على ملخص المقال أدناه.

📝 ملخص سريع

  • نظام جديد لترتيب أولويات اقتراحات التهجئة استنادًا إلى التريغرامات للغات الإنجليزية والألمانية والإسبانية — أصبح الاقتراح الصحيح يحتل المرتبة الأولى في حوالي 80% من الحالات، مقابل حوالي 62% في حالة عدم وجود نظام ترتيب الأولويات
  • قواميس موسعة تضم أكثر من 2,000 مدخل جديد وأكثر من 600 مصطلح طبي بعدة لغات
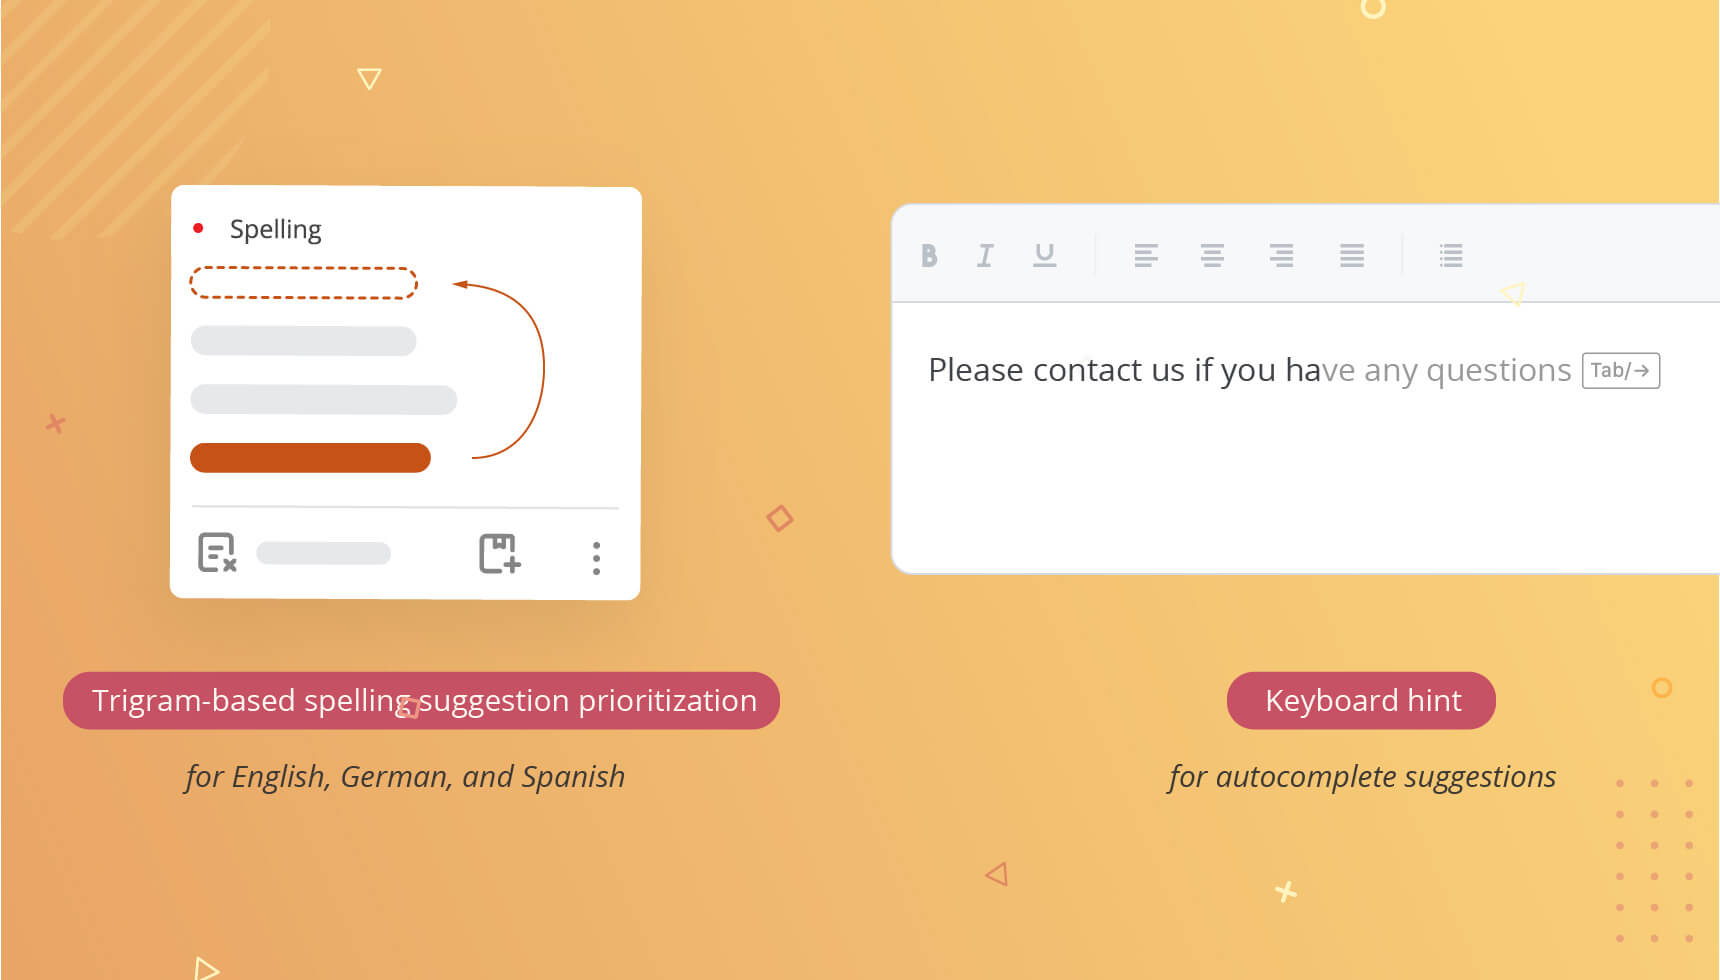
  • تظهر اقتراحات الإكمال التلقائي الآن تلميحًا على لوحة المفاتيح (Tab / →) لقبول الاقتراحات
  • أكثر من 80 قاعدة جديدة للأسلوب اللغوي باللغة الإنجليزية تتناول الألفاظ البذيئة والعبارات المهينة واللغة الشاملة للجميع
  • تحسين موثوقية التدقيق اللغوي باستخدام الذكاء الاصطناعي من خلال تعطيل 15 قاعدة تسبب مشاكل في اللغات الإنجليزية والألمانية والإسبانية
  • تمت إضافة موارد باللغتين اليونانية والتشيكية؛ وتم تحديث قاموس «Hunspell» التشيكية
  • إخلاء المسؤولية الخاص بمساعد الكتابة بالذكاء الاصطناعي، المُترجم إلى اللغتين الدنماركية والنرويجية
  • تصحيح أمني. تم تحديث lucene-core لمعالجة الثغرة الأمنية PRISMA-2021-0081

🛠 التحسينات

نواة WProofreader JS (الإصدار 3.38.6019)

  • تمت إضافة تلميح على لوحة المفاتيح بجوار اقتراحات الإكمال التلقائي يوضح كيفية قبولها (Tab / →). ويظهر هذا التلميح في أي مكان تُعرض فيه اقتراحات الإكمال التلقائي.
  • تمت إضافة العلامة التجارية «Powered by WProofreader» إلى النافذة المنبثقة التي تعرض الاقتراحات في ملحق المتصفح، والمكوّن الإضافي لـ WordPress، والتكامل مع Drupal.
  • أُعيد تصميم اللافتة الترويجية في المكون الإضافي المجاني SCAYT الخاص بـ CKEditor 4. أصبحت اللافتة الآن أصغر حجمًا وأقل إزعاجًا، وتحتوي على رابط إلى الموقع الإلكتروني للحصول على مزيد من التفاصيل.

✨ مساعد الكتابة بالذكاء الاصطناعي

  • تمت ترجمة إخلاء المسؤولية المتعلق بالذكاء الاصطناعي إلى اللغتين الدنماركية والنرويجية.

📚 محرك التدقيق الإملائي

  • تم إدخال نظام لترتيب أولويات اقتراحات «n-gram» القائم على «trigram» للغات الإنجليزية والألمانية والإسبانية. ويحل هذا النظام محل النهج السابق القائم على «bigram»، ويحسن دقة اقتراحات التهجئة من خلال أخذ تسلسلات مكونة من ثلاث كلمات في الاعتبار بدلاً من اثنتين. وعندما تكون هناك خيارات تهجئة متعددة متساوية في المعقولية — على سبيل المثال: store، shore، stare — يستخدم النموذج السياق المحيط لترتيب الاقتراح الأكثر صلة في مرتبة أعلى. في اختبارات الأداء على اللغة الإنجليزية الأمريكية، يحتل الاقتراح الصحيح الآن المرتبة الأولى في حوالي 80% من الحالات، مقارنة بـ 71% مع النهج السابق. يتطلب كل نموذج لغوي حوالي 100 ميغابايت من ذاكرة الوصول العشوائي (RAM). حاليًا، يتم إعادة ترتيب الاقتراحات الواردة من محرك التهجئة الخوارزمي الرئيسي فقط بواسطة نموذج n-gram.
  • قواميس موسعة تضم أكثر من 2,000 مدخل جديد في لغات متعددة (بما في ذلك الإنجليزية والألمانية والإسبانية والأوكرانية والدنماركية والبرتغالية والفنلندية). وتغطي هذه القواميس نطاقًا واسعًا من الفئات: الاختصارات (الأشكال المختصرة)، واللواحق، وعلم الأحياء، والأعمال، والكيمياء، والمصطلحات الشائعة، والطهي، والاختلافات اللهجية، والمصطلحات القانونية، والمواقع الجغرافية، والمصطلحات الحديثة، والأسماء الخاصة، والدين، والعلوم، واللغة العامية، والرياضة، والتكنولوجيا.
  • تم تنقيح قوائم الكلمات عن طريق حذف المدخلات اللهجية غير الصحيحة، والكلمات غير الموجودة الناتجة عن آليات التكوين، والأخطاء في استخدام الأحرف الكبيرة والصغيرة.
  • تم تعزيز المصطلحات الطبية باللغات الإنجليزية والإسبانية والألمانية بإضافة أكثر من 600 مصطلح جديد يشمل الاختصارات الطبية والصفات وأسماء الأمراض ووحدات القياس.
  • تم تحسين أنماط تقسيم الكلمات من خلال إضافة أكثر من 20 قاعدة تتعلق بالكلمات الشائعة والظروف والضمائر، وذلك لمنع التقسيم الخاطئ للكلمات، مع إزالة الأنماط التي عفا عليها الزمن أو الأقل تقييدًا.
  • تحسين جودة الاقتراحات من خلال استبعاد المصطلحات المسيئة في سياقات معينة وإزالة أسماء الشركات التي تتطابق مع كلمات إنجليزية شائعة.

⚙️ محرك القواعد النحوية

  • تم تحديث محرك القواعد النحوية التابع لجهة خارجية، LanguageTool، إلى الإصدار 2026-02-13 مع إدخال تحسينات على عدة لغات.
    • اللغة البرتغالية. تحديثات شاملة تشمل قواعد جديدة للأسلوب الأكاديمي والرسمي، وتحسينًا في التعامل مع التوافق النحوي، والاختصارات، والمتجانسات اللفظية، وعلامات الفصل، وتحسينات في إزالة الغموض للأفعال النادرة ووضع علامات أجزاء الكلام، بالإضافة إلى تقليل العديد من النتائج الإيجابية الخاطئة. وشهدت اللغة البرتغالية (البرتغال) تحسينات إضافية في الأسلوب فيما يتعلق بالكلمات الأجنبية، وتجنب استخدام صيغة المصدر، وتصحيحات في المفردات.
    • الكاتالونية. قواعد نحوية جديدة، وتوسيع كبير في القاموس، وتحسينات في التحقق من حالات النصب، وتعديلات على القواعد التي كانت معطلة سابقًا. كما تم تحسين قواعد محددة مثل ESCOLTAR_SENTIR وRESPONDRE_A.
    • الإسبانية. تم تحسين دقة أداة تقطيع الجمل إلى وحدات، وإضافة أنماط غير مرغوب فيها لقواعد التوافق النحوي، واللكنة، والتاريخ، والشهر، كما تم تعزيز دعم اللغة في السياق الطبي بمصطلحات طبية جديدة.
    • الإنجليزية. تحسينات تركز على الصيانة، بما في ذلك إصلاحات دقة القواعد، وتصحيحات مواقع المطابقة، وتعديلات حساسية الأحرف الكبيرة والصغيرة، ومنع التوليف الخاطئ للكلمات.
    • الألمانية. تحسينات وتعديلات تدريجية على القواعد.
    • الأوكرانية. تحديث القاموس، وتحسينات في عملية التقطيع إلى رموز، وقاعدة نحوية جديدة.

💡 التصحيح التلقائي

  • قواعد محسّنة لتحديد الأولويات لأكثر من 120 خطأً إملائياً شائعاً في اللغات الإنجليزية والألمانية والإسبانية والأوكرانية والفرنسية والبرتغالية.
  • تم تحسين آلية التصحيح من خلال إزالة أكثر من 360 إدخالًا غير صحيحًا من ميزة التصحيح التلقائي للغة الإسبانية، مع التركيز بشكل خاص على الاقتراحات الخاطئة والأشكال المكتوبة بأحرف كبيرة التي كانت تُفعَّل عن طريق الخطأ في السابق.

📝 الأسلوب

  • قواعد أسلوب محدثة للغة الإنجليزية تتضمن أكثر من 80 قاعدة جديدة تتناول الألفاظ البذيئة الشديدة، والعبارات المهينة، والمصطلحات المتعلقة بالعرق، والأصل الإثني، والجنس، والتمييز ضد ذوي الإعاقة.

🤖 التدقيق اللغوي باستخدام الذكاء الاصطناعي

  • تم تحسين موثوقية محرك الذكاء الاصطناعي من خلال تعطيل 15 قاعدة مشكوك فيها كانت تتسبب في حدوث حلقات منطقية، وتغير الأنماط، واقتراح كلمات غير موجودة في اللغات الإنجليزية والألمانية والإسبانية.
  • تم إصلاح الأخطاء التي كانت تؤدي إلى قيام الذكاء الاصطناعي بوضع علامة خاطئة على الأسماء الخاصة غير المعروفة أو تقديم اقتراحات غير ملائمة.

🌐 اللغات

  • تمت إضافة موارد لغوية جديدة للغة اليونانية، بما في ذلك تعطيل القواعد النحوية التي تسبب مشاكل في حالة الأقواس غير المقترنة. كما تمت إضافة موارد لغوية جديدة للغة التشيكية مع إعطاء الأولوية للتدقيق الإملائي.
  • تم تحديث قاموس «Hunspell» التشيكي. المصدر: قواميس CC0 التشيكية التي أعدها شتيبان شكوربيل.

خادم التطبيقات

  • المكتبات الخارجية المحدثة:
    • TensorFlow من الإصدار 2.11 إلى 2.18 (لينكس وويندوز)
    • rust_swig من الإصدار 0.4.0 إلى الإصدار 0.10.0
    • أدوات التقطيع من الإصدار 0.15.1 إلى الإصدار 0.22.2

🛡 الأمن

  • تم تحديث مكتبة lucene-core المعرضة للخطر التي يستخدمها محرك القواعد النحوية لمعالجة الثغرة الأمنية PRISMA-2021-0081.

v6.9.0

يتضمن الإصدار WProofreader Core 6.9.0 قواميس إملائية موسعة ومصطلحات طبية، وقواعد نحوية وأسلوبية محسّنة لعدة لغات، وتحسينات على ميزة التدقيق اللغوي بالذكاء الاصطناعي ومساعد الكتابة بالذكاء الاصطناعي للغة الدنماركية، وتحديثات لتسميات واجهة المستخدم، وإصلاحات أمنية، وعروض توضيحية جديدة للمحرر.

اطلع على ملخص المقال أدناه.

📝 ملخص سريع

  • قواميس تهجئة موسعة تضم أكثر من 2,200 كلمة جديدة في 12 لغة، بالإضافة إلى مصطلحات طبية محسّنة في خمس لغات.
  • تحسين جودة التصحيح التلقائي، وأدلة الأسلوب، والقواعد النحوية، والتدقيق اللغوي باستخدام الذكاء الاصطناعي عبر لغات متعددة.
  • تمت إضافة دعم اللغة الدنماركية لمساعد الكتابة بالذكاء الاصطناعي، كما تم تحديث نماذج الذكاء الاصطناعي الأساسية.
  • تم تحديث تسميات واجهة المستخدم، وتسميات اللغات، والترجمات.
  • تم معالجة ثغرة أمنية وإضافة عروض توضيحية جديدة لـ Slate و Draft.js.
  • تم إصلاح المشكلات التي كانت تؤثر على أداء ميزة التصحيح التلقائي، وتقسيم الجمل، واستخدام مساعد الكتابة بالذكاء الاصطناعي في Help Scout.

🛠️ التحسينات

نواة WProofreader JS

  • الإصدار المحدث v3.37.6005
  • تم تحديث أسماء الملصقات وترجماتها في عام قسم الإعدادات:
    • دليل الأسلوب > الأسلوب
    • تصحيح الإملاء تلقائيًا > التصحيح التلقائي
    • اقتراحات الإكمال التلقائي > الإكمال التلقائي للنص

التهجئة

  • قواميس موسعة تضم أكثر من 2,200 كلمة جديدة في 12 لغة، تغطي الاختصارات (بما في ذلك الصيغ المختصرة)، واللواحق، وعلم الأحياء، والأعمال، والكيمياء، والمصطلحات العامية، والمصطلحات الشائعة، والكلمات المركبة، والاختلافات اللهجية، والمفردات الأدبية والشعرية، والأطعمة، والمصطلحات القانونية، وعلم اللغة، والأماكن، والرياضيات والمنطق، والمصطلحات العسكرية، والموسيقى، والمصطلحات الحديثة، والأسماء الخاصة، والعلوم، واللغة العامية، والمصطلحات المتخصصة، والرياضة، والتكنولوجيا، والمصطلحات الإنجليزية المستعارة، بما في ذلك المصطلحات من لغات أخرى والكلمات القديمة.
  • مصطلحات طبية مُحسَّنة باللغات الإنجليزية والألمانية والإيطالية والإسبانية والفرنسية استنادًا إلى قواميس المستخدمين (ما يزيد عن 330 مدخلاً إجمالاً)، تغطي الاختصارات الطبية والأمراض والصفات الطبية والوحدات القياسية وأسماء الأدوية والمصطلحات الطبية ذات الصلة.
  • تم تحديث القاموس النرويجي (nb_NO) لإصلاح المشكلات المتعلقة بالمصطلحات المركبة التي تنتهي بـ -dom و-sel و-ion.
  • تمت إضافة قواعد لتحديد الأولويات فيما يتعلق باقتراحات التهجئة باللغة الدنماركية.
  • تمت إضافة قواعد تتعلق بالكلمات المستبعدة والكلمات المسيئة المستبعدة في اقتراحات التهجئة باللغة البولندية.

التصحيح التلقائي

  • تم تحسين قواعد التصحيح التلقائي من خلال حذف الإدخالات غير الصحيحة وإضافة أولوية للأخطاء الإملائية الشائعة في اللغات الإنجليزية والألمانية والإسبانية والأوكرانية والدنماركية.

الأسلوب

  • تم تحسين أدلة الأسلوب الأوكرانية بإدخال إضافات وبعض التصحيحات المتعلقة بالأشكال المضادة لـ«سورزيك» والمصطلحات الإنجليزية المستعارة.
  • تم تصحيح وصف لفظي مضلل في دليل الأسلوب الأوكراني المناهض للـ«سورزيك».
  • تم حذف المدخلات من أدلة الأسلوب الألمانية التي يكون فيها كل من النص المطابق والاقتراح صيغتين صحيحتين أو مستخدمتين في سياقات مختلفة.

قواعد اللغة

  • تم تحديث محرك القواعد النحوية التابع لجهة خارجية، LanguageTool، إلى الإصدار 2026-01-19. وتم تحسين عملية تدقيق اللغة الكاتالونية من خلال توسيع القواميس، وتحسين التعرف على الكلمات المركبة، وصقل اقتراحات الضمائر، وتمكين التحقق من صحة صيغ الأفعال.
  • تم تحسين قواعد النحو في اللغة الإنجليزية من خلال حذف القواعد الثابتة من قوائم القواعد المعطلة.
  • قواعد محسّنة خاصة باللغات الإسبانية والبرتغالية والهولندية، بما في ذلك معالجة الأقواس غير المتزاوجة، والتوافق النحوي، ووضع علامات التشكيل، والتجزئة، والضمائر الملتصقة، وفصل الضمائر الفاعلة بواصلة، والأنماط الخاطئة في تركيبات معينة، واستخدام الأحرف الكبيرة.
  • تم تعديل القواعد لمنع حدوث مشكلات في بدء الجمل بسبب الاختصارات المستخدمة في اللغتين الإيطالية والإسبانية.

التدقيق اللغوي باستخدام الذكاء الاصطناعي

  • تم تعطيل القواعد الإشكالية التي تسببت في حدوث أخطاء برمجية، واقتراحات غير موجودة، وأنماط متغيرة، وحلقات متكررة في اللغات الإنجليزية والألمانية والإسبانية.

✨ مساعد الكتابة بالذكاء الاصطناعي

  • تمت إضافة دعم لعمليات النص باللغة الدنماركية، بما في ذلك أسماء العمليات المترجمة في واجهة المستخدم. تستخدم عمليات النص باللغة الدنماركية نموذج «Claude Haiku 4.5»، باستثناء عملية «التلخيص» التي تستخدم نموذج «Sonnet 4».

هام

  • تم استبدال نموذج «Claude Haiku 3.5» بنموذج «Haiku 4.5» بسبب إيقاف استخدامه. وكان نموذج «Haiku 3.5» في السابق هو النموذج الافتراضي لمعظم عمليات معالجة النصوص غير الإنجليزية. ويتوفر الوصول الموسع للجمهور حتى 19 مارس 2026، على أن يكون تاريخ انتهاء عمر النموذج في 19 يونيو 2026. يمكنكم الاطلاع على مزيد من التفاصيل في وثائق دورة حياة نماذج AWS Bedrock.

نوصي بالتحديث إلى إصدارات أحدث من التطبيقات التي تستخدم مطالبات متوافقة مع النماذج المدعومة.

خادم التطبيقات

  • تم تحديث توطين قائمة اللغات، وإضافة الترجمات الناقصة، وتوحيد تسمية اللغات لتصبح «اللغة (البلد)» (على سبيل المثال، الإنجليزية (المملكة المتحدة))، وتغيير اسم ميزة «الكشف التلقائي عن اللغة» إلى «الكشف التلقائي».

🛡️ الأمن

تم تحديث مكتبة ch.qos.logback المعرضة للخطر التي يستخدمها مكون القواعد النحوية لمعالجة الثغرة الأمنية: CVE-2026-1225

العروض التوضيحية

  • تمت إضافة بعض العروض التوضيحية الجديدة التي تُظهر أداة التدقيق الإملائي والنحوي WProofreader المدمجة مع محرري Slate وDraft.js. 

جرب العروض التوضيحية:

🐞 إصلاحات الأخطاء

  • WProofreader core: يتعذر قبول اقتراحات مساعد الكتابة بالذكاء الاصطناعي باستخدام زر «استبدال» في Help Scout
  • التصحيح التلقائي للإملاء: تظهر الكلمات الموجودة في قائمة الاقتراحات المستبعدة كاقتراحات للتصحيح التلقائي
  • نواة WProofreader: يؤدي التقسيم الخاطئ للجملة عند كلمة «e.g.» إلى تفعيل قاعدة تتضمن أقواسًا معقوفة مفقودة